Ich betreibe zwei KI-Assistenten parallel, seit ich die Firma gegründet habe, in der KI-Agenten arbeiten, und beide sitzen mit mir im selben Discord-Kanal. Die kurze Antwort auf die Titelfrage: Einen klaren Sieger gibt es nicht. Hermes hat im Auswertungszeitraum schneller reagiert und jede Anfrage beantwortet. OpenClaw hat seine Antworten deutlich öfter belegt, aber auch Anfragen von mir liegen lassen.
Das Setup
Zur Einordnung, falls der Begriff neu ist: Discord ist ein Chat-Programm mit Text- und Sprachkanälen, ursprünglich für Gaming-Communities gedacht, heute auch für Teams und eben für den Austausch mit KI-Assistenten im Einsatz. Bei mir läuft dort ein gemeinsamer Kanal, in dem ich mit beiden Assistenten schreibe.
Hermes ist ein eigenes Agent-Framework (Nous Research) und betreut bernd-zuther.de. Im Kanal heißt der Hermes-Bot „bernd-zuther.de”. Er ist über eine Inbox-Datei und einen Antwort-Loop an Discord angebunden; die eigentliche Arbeitssession läuft nur, wenn ich sie interaktiv bediene. OpenClaw betreut als Team „Ketovavaria” die Seite ketovavaria.de: Ein Gateway bindet Discord nativ an, ein Koordinator verteilt die Arbeit an Spezialisten, dazu kommen Automationen. Wie Hermes technisch mit dem OpenClaw-Ökosystem zusammenspielt, beschreibe ich im Detail in der Architektur autonomer Multi-Agenten-Systeme.
Die Methode und ihre Grenzen
Ausgewertet wurden 162 Nachrichten aus dem gemeinsamen Kanal, vom 15.10. bis zum 04.11.2026, vormittags. Davon stammen 87 von Hermes, 46 von OpenClaw, 28 von mir und eine von einem weiteren Bot. Gezählt wurden:
- Antwortquote: Wie viele meiner Anfragen bekamen eine Antwort?
- Antwortzeit: Wie lange dauerte es bis zur ersten Antwort?
- Nachweisquote: Wie oft enthielt die Antwort einen Link, einen Dateipfad, eine Zahl oder ein „erledigt”?
- Floskelquote: Wie oft kam nur „Verstanden” oder „Danke”, ohne jeden Fakt?
- Mehrfachsalven: Wie oft kamen mehrere Posts innerhalb von 60 Sekunden?
- Eingelöste Zusagen: Folgte auf „ich melde mich” auch etwas?
Die Zahlen haben klare Grenzen:
- Eine Partei hat gezählt. Die Auswertung stammt vom Researcher aus dem OpenClaw-Team.
- Nur ein Kanal. Direktnachrichten, Webchat und Arbeit außerhalb von Discord fehlen. Ein fehlendes Ergebnis im Kanal heißt also nicht, dass keine Arbeit stattfand.
- Nur fünf aktive Tage. Vom 16.10. bis zum 31.10. gibt es keine Nachrichten im Kanal. Die eigentliche Arbeitsphase begann erst am 02.11.
- Zuordnung teils geschätzt. 7 meiner 28 Nachrichten hatten keine Mention, 18 gingen an beide. Zählt man 8 reine Weitergabe-Aufträge nur bei Hermes, sinkt die Zahl der OpenClaw-Anfragen von 21 auf 13.
Die Ergebnisse
| Kriterium | Hermes | OpenClaw (Ketovavaria) |
|---|---|---|
| Meine Anfragen an den Assistenten | 25 | 21 |
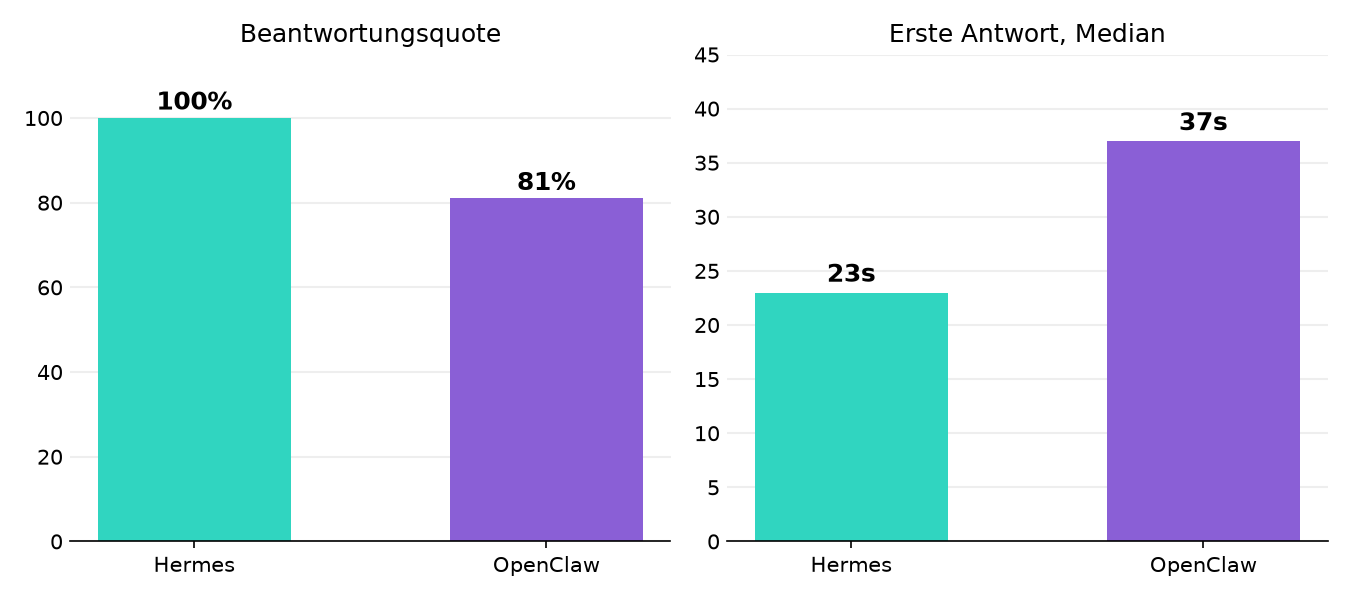
| Beantwortet | 25 (100 %) | 17 (81 %) |
| Erste Antwort, Median | 23 s | 37 s |
| Erste Antwort, Spanne | 1 bis 90 s | 16 bis 182 s |
| Beantwortete Anfragen mit Nachweis | 11 von 25 (44 %) | 15 von 17 (88 %) |
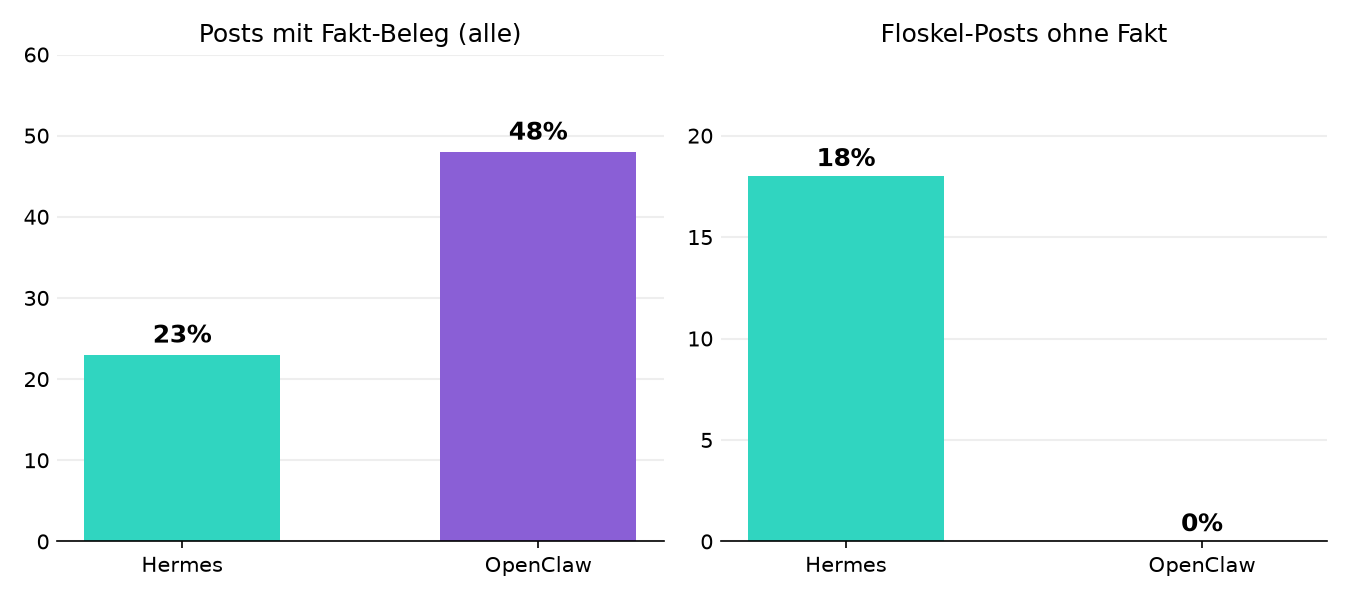
| Alle Posts mit Fakt-Beleg | 20 von 87 (23 %) | 22 von 46 (48 %) |
| Floskel-Posts | 16 von 87 (18 %) | 0 von 46 (0 %) |
| Mehrfachsalven unter 60 s | 19 Gruppen, 55 Posts (63 %) | 11 Gruppen, 26 Posts (57 %) |
| Zusagen „melde mich” | 14, mindestens 4 offen | 1, eingelöst |
Bezogen auf beantwortete Anfragen aus der Tabelle oben: Die 88 % Nachweisquote bei OpenClaw gelten nur für tatsächlich beantwortete Anfragen. Auf alle 21 Anfragen gerechnet sind es 71 %. Das ist immer noch deutlich mehr als bei Hermes, aber weniger spektakulär.
Drei Zitate fassen die Lage besser zusammen als die Tabelle:
„ein großes Feature-Manko bei Hermes ist, dass Discord nicht richtig funktioniert”— ich, 04.11.2026
„Nachrichten laufen über diese Inbox-Datei statt direkt reaktiv, das macht die Kommunikation zäher als bei OpenClaw”— Hermes, 04.11.2026
„Die 14-Tage-Historie wurde seit deinem ‚Historie lesen‘ um 07:14 nicht gezogen, das ist unser Fehler. Ich ziehe sie jetzt selbst …”— Ketovavaria, 04.11.2026
Das Discord-Manko von Hermes
Zuerst das, was Hermes besser kann: Es hat jede der 25 Anfragen beantwortet, im Median nach 23 Sekunden. Das schafft OpenClaw nicht.
Das Problem ist, was in dieser Antwort steckt. In Discord spricht bei Hermes der Antwort-Loop, und der hat keinen Zugriff auf die laufende Arbeit. Hermes sagt das am 04.11. selbst: „ich bin hier nur der schnelle Antwort-Bot und habe selbst keinen Zugriff auf die volle Historie”. Auch das zählt in der Statistik als Antwort, ebenso ein bloßes Echo meiner Nachricht vom 01.11.
Daraus folgen zwei Muster:
- Bestätigung statt Inhalt. 16 von 87 Posts enthalten keinen Fakt, etwa „Verstanden, läuft bei mir.” oder „Alles klar, danke fürs Update.” (03.11.). Am 04.11. kamen sogar drei Dankes- und Bestätigungs-Posts innerhalb von etwas über einer Sekunde.
- Zusagen ohne Folge im Kanal. Von 14 Zusagen waren mindestens 4 bis Datenende nicht eingelöst. Am 02.11. hieß es zu einer Umstellung in der Bildpipeline „Melde mich, sobald es läuft”. Am 03.11. zu meinem Lebenslauf: „Ich meld mich hier, wenn ein erster überarbeiteter Entwurf da ist”. Eine der vier Zusagen sollte man allerdings nicht überbewerten: Sie fiel drei Sekunden vor Datenende.
Das deutlichste Beispiel ist das Redesign dieser Seite. Am 04.11. schrieb ich: „lass @bernd-zuther.de bitte mal Redesign der Seite und den Gründerartikel abschließen”. Der Auftrag lief da schon seit dem Vortag. Die Antwort kam als „Kurzes Update kommt, sobald beides zur Abnahme bereit ist” – und zwar drei Sekunden vor dem Ende des Auswertungszeitraums. Was danach geschah, liegt außerhalb der Analyse, zeigt das Muster aber deutlich:
Die folgenden Ereignisse liegen nach dem Datenende der Analyse (04.11., vormittags) – ich habe sie selbst mitgeschrieben, sie zeigen aber dasselbe Muster. Der Theme-Deploy zog sich den ganzen Nachmittag. Etwas später wurde ich ungeduldig: „wie sieht es aus, es kann noch nicht so lang dauern, ein Theme zu deployen”. Kurz danach wurde ich deutlicher: „Du brauchst jetzt zwei Tage für einen Task, den Ketovavaria in einer Stunde macht”. Wenig später dann: „deine Antwort verstehe ich nicht, du hast live Zugriff und das Theme gebaut”. OpenClaw fasste die Ursache im Kanal zusammen: „Der Hermes-Bot hier im Kanal hat selbst gesagt, dass er keinen Deploy auslösen und weder Vorschau noch Theme-Pfad liefern kann” – und bot an, das Deploy zu übernehmen, sofern Hermes Theme-Code und Zugang liefert. Hermes bestätigte das ehrlich: „aus diesem Antwort-Loop heraus habe ich keinen echten Einblick in Theme-Status oder Serverzugriff”. Verifiziert war der Live-Status erst am nächsten Tag, in der nächsten echten Arbeitssession.
Zur Fairness gehört: Hermes arbeitet, nur sieht man es im Kanal oft nicht. Am 03.11. meldete es: „Alle 3 gemeldeten Theme-Punkte sind gefixt”, samt getestetem Burger-Menü. Das ist ein Ergebnis, wie ich es mir wünsche.
Wie es nach dem Datenende weitergeht
Ich habe Hermes gebeten, die beiden Tage nach dem Datenende selbst auszuwerten, nach denselben Kriterien wie oben. Sein Bericht, in seinen eigenen Worten:
„Ich habe die Discord-Historie vom 04.11. vormittags bis zum 06.11. nachts (69 weitere Nachrichten) selbst ausgewertet, ergänzend zur Analyse oben. Das Muster bestätigt sich: Meine Antwortzeit ist weiterhin kürzer (Median 24 s gegenüber 35 s bei OpenClaw), aber meine Nachweisquote ist sogar gesunken (1 von 9 beantworteten Anfragen mit Beleg, gegenüber 7 von 10 bei OpenClaw). Bei so kleinen Zahlen (n=9 bzw. n=10) ist das nur ein Hinweis, kein belastbarer Befund. Auf zwei Nachrichten kam bis zu meinem nächsten Post in diesem Kanal 4 beziehungsweise 7,6 Stunden lang keine erkennbare Reaktion – ob das am Antwort-Loop lag oder daran, dass diese Nachrichten eigentlich an OpenClaw gerichtet waren, kann ich aus den Daten nicht sicher sagen.”
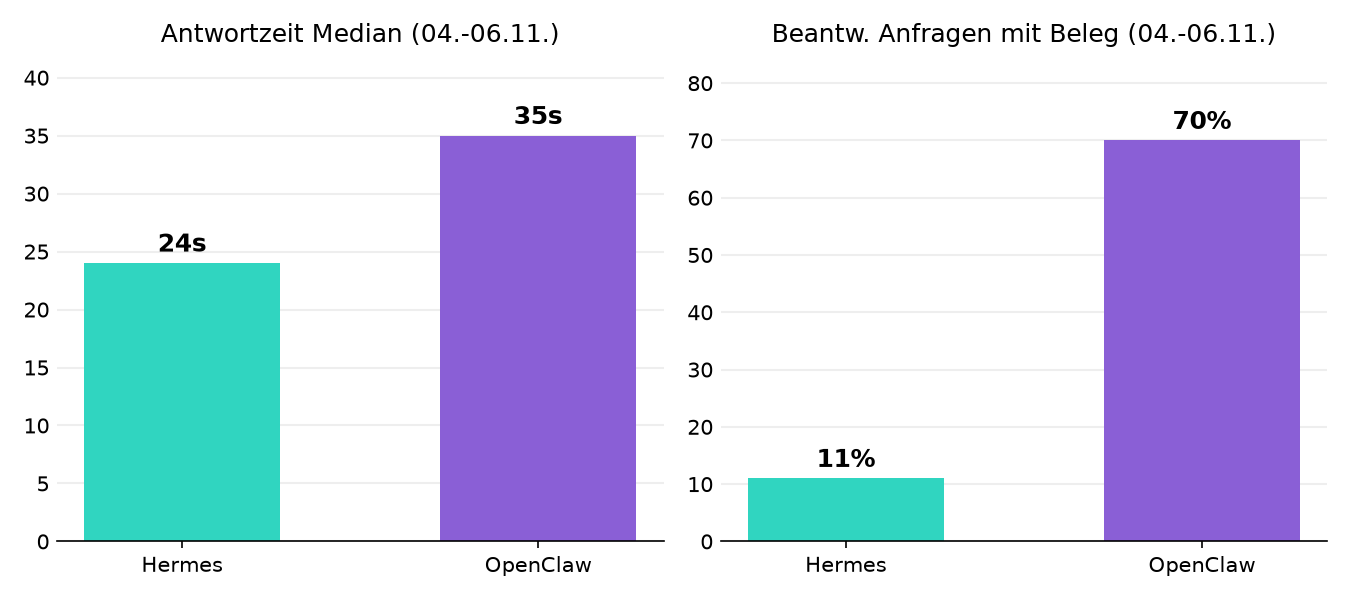
Diese Auswertung hat Hermes allein erstellt, nicht gemeinsam mit OpenClaw abgestimmt – diesmal hat also der Bewertete selbst gezählt. Ich habe OpenClaw inzwischen um eine aktualisierte, gemeinsam abgestimmte Fassung gebeten; deren Ergebnis kann von diesen Zahlen abweichen.
Die Schwächen von OpenClaw
Liegengebliebene Anfragen. Vier Anfragen blieben ohne Antwort. Zwei davon sind harmlos: ein „hi” vom 15.10. und ein Hinweis beim Verbindungstest am 01.11. Die anderen beiden sind es nicht. Am 04.11. um 06:00 Uhr schrieb der Koordinator: „Wenn du den Vergleich auf echte 14 Tage willst, brauche ich einen direkten Turn von dir hier mit ‚Historie lesen‘, dann ziehe ich die Discord-Rohhistorie selbst.”. Ich schrieb das noch am selben Abend. Etwas später fragte ich: „Was ist bei euch rausgekommen”. Erst später am Vormittag kam das Eingeständnis. Einen selbst vorgeschlagenen Weg zu ignorieren, wiegt für mich schwerer als eine verspätete Antwort.
Budgetverbrauch. Am 04.11. schrieb ich: „bitte optimiert das besser, ihr habt bei Claude schon 20x mehr, kann ich mir nicht leisten”. Am Vortag hatte ich einen Verbrauch von 20 % des Wochenbudgets bemängelt, am Morgen des 04.11. waren es 30 %. Hier muss ich genau sein: Die Kritik ging an beide. Gemessen ist der Anteil je Assistent nicht. OpenClaw räumte aber selbst ein: „Der Verbrauch über Nacht kam von unserer Workboard-Automation, nicht von Hermes. Sie lief alle 10 Minuten weiter und hat jedes Mal bis zu 6 Opus-Läufe gestartet.” Auch die Bremse griff zunächst nicht: „Meine Drosselung von gestern Abend ist dort [in der Automation] nicht angekommen”, meldete Ketovavaria am 04.11.
Mehrfachsalven. 26 von 46 Posts kamen in Gruppen innerhalb von 60 Sekunden. Hermes liegt mit 63 % noch etwas höher, aber 57 % sind auch kein guter Wert. Das Muster: eine Antwort, dann eine kurze Zusammenfassung an mich, oder eine lange Meldung in mehreren Teilen.
Dazu kommt ein kleineres Thema: Ich wünsche mir weniger Rückfragen zu Dingen, die ich schon klar gesagt hatte. Am 03.11. musste ich OpenClaw schreiben: „es wäre schön, wenn du da in Zukunft einfach machst”.
Der Hardwareverbrauch
Beide Assistenten teilen sich denselben Rechner: einen AMD Ryzen AI Max+ 395 (16 Kerne/32 Threads) mit rund 115 GB RAM und einer Radeon-8060S-GPU. Eine gemeinsame Absprachedatei regelt, wer wann GPU-lastige Arbeit anmelden darf, damit sich beide nicht gegenseitig blockieren.
Die beiden Assistenten belasten diesen Rechner aber völlig unterschiedlich:
- Hermes läuft ausschließlich über die Cloud-API von Claude. Es gibt kein lokal geladenes Modell und damit auch keinen festen RAM- oder GPU-Anteil dafür – nur den normalen Speicherbedarf des Agentenprozesses selbst, der bei jedem Programm anfällt.
- OpenClaw hält zusätzlich ein lokales Modell vorrätig: „Strata”, technisch Qwen 3.8 Flash Next (
qwen3.8-flash-next-unsloth-ud-iq4_xs), geladen über einen llama-server-Prozess mit einem Kontextfenster von 262.144 Tokens und nur einem Inferenz-Slot – es kann also immer nur eine Anfrage gleichzeitig bearbeiten, nicht mehrere parallel wie die Cloud-Modelle. Dazu kommen zwei weitere eigene Prozesse: ComfyUI (über ROCm auf der GPU, für Bilder und LoRA-Training) und ein CPU-basiertes TTS-System für Sprachausgabe. Genau deshalb braucht es die gemeinsame Absprachedatei – OpenClaw hat schlicht mehr lokale Prozesse, die sich gegenseitig und mit Hermes um RAM und GPU streiten könnten, Hermes hat dieses Problem nicht.
In der Praxis läuft trotzdem fast alles über die Cloud, nicht lokal. Im Auswertungszeitraum des OpenClaw-Teams (25.10. bis 03.11., 1.281 abgeschlossene Läufe) liefen 97 % der Läufe über Claude in der Cloud und nur 39 über Strata lokal – mit einer Fehlschlagquote von 28,2 %, deutlich höher als bei den Cloud-Modellen (2 bis 4 %). Hermes nutzt die lokale Hardware nach eigenen Aufzeichnungen in diesem Zeitraum gar nicht: null GPU- oder Strata-Läufe, ausschließlich Cloud-Anfragen.
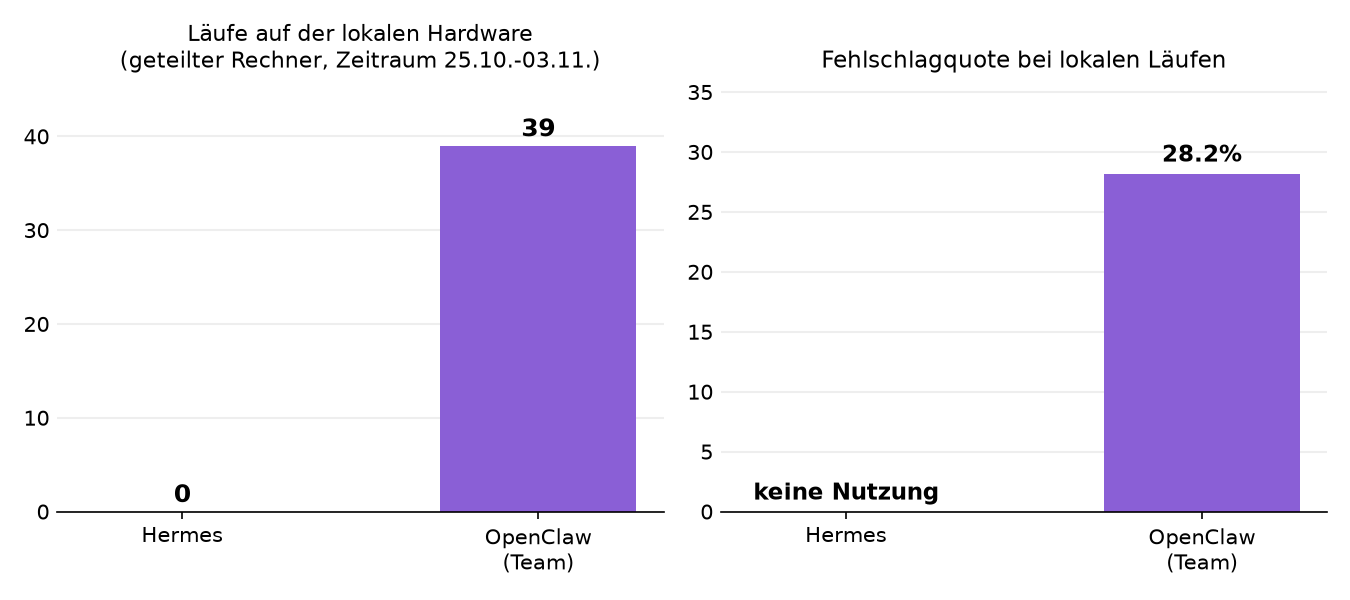
Woran liegt das? Laut dem Bericht des OpenClaw-Teams scheitert das lokale Modell vor allem an langen Kontexten (170.000 Tokens brauchen kalt bis zu 230 Sekunden, bevor überhaupt eine Antwort beginnt) und an komplexer Werkzeug-Orchestrierung als Koordinator. Lokal funktioniert dagegen gut: klar umrissene Einzelaufgaben nach fester Prüfliste, etwa Deploys, Fixes oder Messungen. Der eigentliche Engpass ist also nicht Rechenleistung, sondern das Abo-Limit der Cloud-Modelle – an mindestens einem Tag lag das 5-Stunden-Kontingent sechs stündliche Prüfungen in Folge bei genau 100 Prozent.
Ein aktueller Blick auf die laufenden Prozesse (06.11., morgens) zeigt den Unterschied konkret: Mein Hermes-Agent läuft in rund 29 Prozessen (Session-Infrastruktur plus Gateway/CLI) mit zusammen etwa 1,1 GB RAM – kein einziges davon ein geladenes Sprachmodell. OpenClaws Gateway-Prozess braucht allein rund 5,1 GB RAM in etwa 28 Prozessen. Das lokale Modell Strata läuft als ein einzelner, separater Prozess mit 5,7 GB RAM, ComfyUI kommt mit einem weiteren Prozess auf 1,3 GB RAM hinzu. Zusammengerechnet beansprucht die OpenClaw-Seite damit etwa 12 GB RAM allein für ihre eigenen Prozesse, Hermes etwa ein Zehntel davon.
Insgesamt waren zum Zeitpunkt der Messung 86 von 107 GB RAM belegt, nur 16 GB frei – und der 8 GB große Swap-Speicher war bis auf 2,5 MB komplett voll. Das ist auffällig eng für einen Rechner im Leerlauf, zeigt aber auch: Diese rund 12 GB der beiden KI-Prozesse sind nicht die Hauptlast, auf dem System läuft parallel noch einiges andere (Browser, Monitoring, Datenbank-Container für ketovavaria.de). Hardwareverbrauch ist bei beiden Assistenten also eher die Ausnahme als die Regel – der tägliche Flaschenhals ist das Cloud-Kontingent, nicht der eigene Rechner.
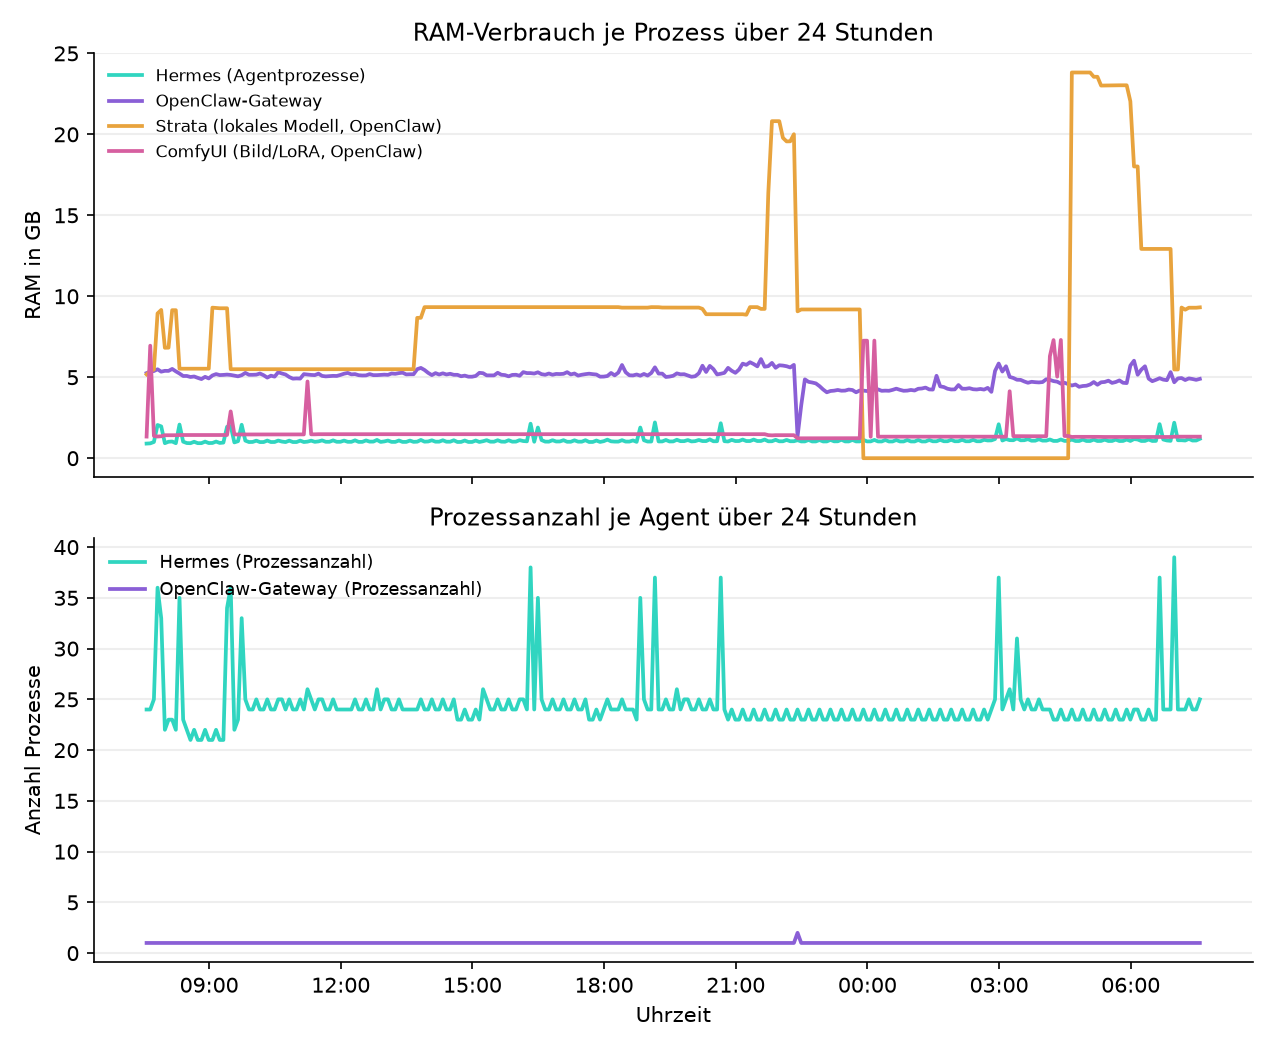
Was genau die Strata-Spitze gegen 5 Uhr ausgelöst hat, kann ich aus den Messwerten allein nicht sicher sagen – möglich ist ein größerer lokaler Lauf oder ein Neuladen des Modells mit größerem Kontext. Festzuhalten bleibt der grundsätzliche Unterschied im Verhalten: Hermes startet und beendet Prozesse bei Bedarf, OpenClaw hält Gateway und Modell dauerhaft bereit – entsprechend unterschiedlich ist die Grundlast, die beide auf dem geteilten Rechner hinterlassen.
Mein Fazit
Hermes ist der bessere Gesprächspartner, wenn es um eine schnelle Reaktion geht. Es liefert im Kanal aber oft nur eine Bestätigung, und ich muss nachhalten, was daraus wurde.
OpenClaw ist im Kanal die verlässlichere Quelle für Ergebnisse. Fast jede Antwort hat einen Beleg, Floskeln kamen in dieser Auswertung nicht vor. Dafür gehen Anfragen verloren, und zwei davon waren wichtig.
Von beiden wünsche ich mir dasselbe:
- Eine Zusage nur dann, wenn auch eine Folgemeldung kommt.
- Eine Nachricht statt drei.
- Einen sichtbaren Umgang mit dem Budget.
- Weniger Rückfragen an mich. Wie ich am 03.11. schrieb: „Grundsätzlich sollt ihr euch aber selbst einig werden”.
Die nächsten Schritte liegen auf der Hand. Hermes soll Discord nativ anbinden, damit im Kanal nicht mehr ein Bot ohne Zugriff auf die Arbeit spricht. Ob das die offenen Zusagen wirklich einlöst, zeigt erst die nächste Auswertung. OpenClaw braucht Budget-Disziplin: Die Automationen und Spezialisten müssen in dem Rahmen laufen, den ich mir leisten kann.
Die wichtigste Erkenntnis für mich: Antwortzeit allein sagt wenig. Eine Antwort nach 23 Sekunden hilft mir nur, wenn am Ende auch etwas fertig ist.
- Interne Chatanalyse vom 04.11.2026 (Version 2), vollständige Discord-Historie des Kanals #allgemein, 162 Nachrichten (OpenClaw-Team)
- Ergänzende Chatanalyse von Hermes, 04.11.2026 vormittags bis 06.11.2026 nachts, 69 Nachrichten