Eine Root-Cause-Analyse hat selten ein glattes Ende. Meine begann mit einer akuten Speicherüberlastung, die meinen Mini-PC lahmlegte – und endete, nachdem das akute Problem längst behoben war, mit einer zweiten, unauffälligeren Diagnose: einer Notfall-Konfiguration, die sich als stiller Dauerschaden festgesetzt hatte, lange nachdem der eigentliche Vorfall vorbei war. Dazwischen lagen zwei falsche Fährten, eine Auswertung von über 8.000 Log-Zeilen und ein Reboot, der das Problem nicht löste, obwohl ich das erwartet hatte.
- Wie eine klassische Swap-Überlastung meinen lokalen Inferenz-Server lahmlegte
- Warum eine unter Zeitdruck gebaute Notfall-Konfiguration zur eigentlichen Ursache einer Performance-Regression wurde – getrennt vom Vorfall, der sie auslöste
- Wie ich mit meinem Hermes-Agenten systematisch Hypothesen getestet und verworfen habe, statt zu raten
- Warum ein funktionierender Reboot ein Symptom beheben kann, ohne die Ursache zu berühren
Incident: Swap-Überlastung legt den Inferenz-Server lahm
Mein Mini-PC – ein Strix Halo S1 Max, auf dem auch mein lokaler Inferenz-Server Strata läuft – wurde an einem Morgen spürbar zäh. Load Average zweistellig bei 32 CPU-Kernen, Arbeitsspeicher komplett belegt, Swap randvoll (8 von 8 GB). Sobald der Swap-Puffer keinen Spielraum mehr hat, verbringt das System mehr Zeit mit Ein- und Auslagern von Speicherseiten als mit eigentlicher Arbeit – klassisches Swap-Thrashing, keine Einzelkomponente ist „kaputt“, das System ist nur strukturell überbucht.
Root Cause des Incidents: Mehrere speicherintensive Prozesse waren praktisch zeitgleich hochgefahren – mein lokales LLM Qwen 3.8 Flash Next (Mixture-of-Experts, 48 Layer) über Strata, konfiguriert mit einem 256K-Token-Kontextfenster und einem festen 40-GB-RAM-Budget für residente Modell-Experten, dazu ein laufendes npm-Update und der OpenClaw-Gateway-Prozess. Jeder für sich unkritisch, in Kombination genug, um den verfügbaren Speicher zu überbuchen.
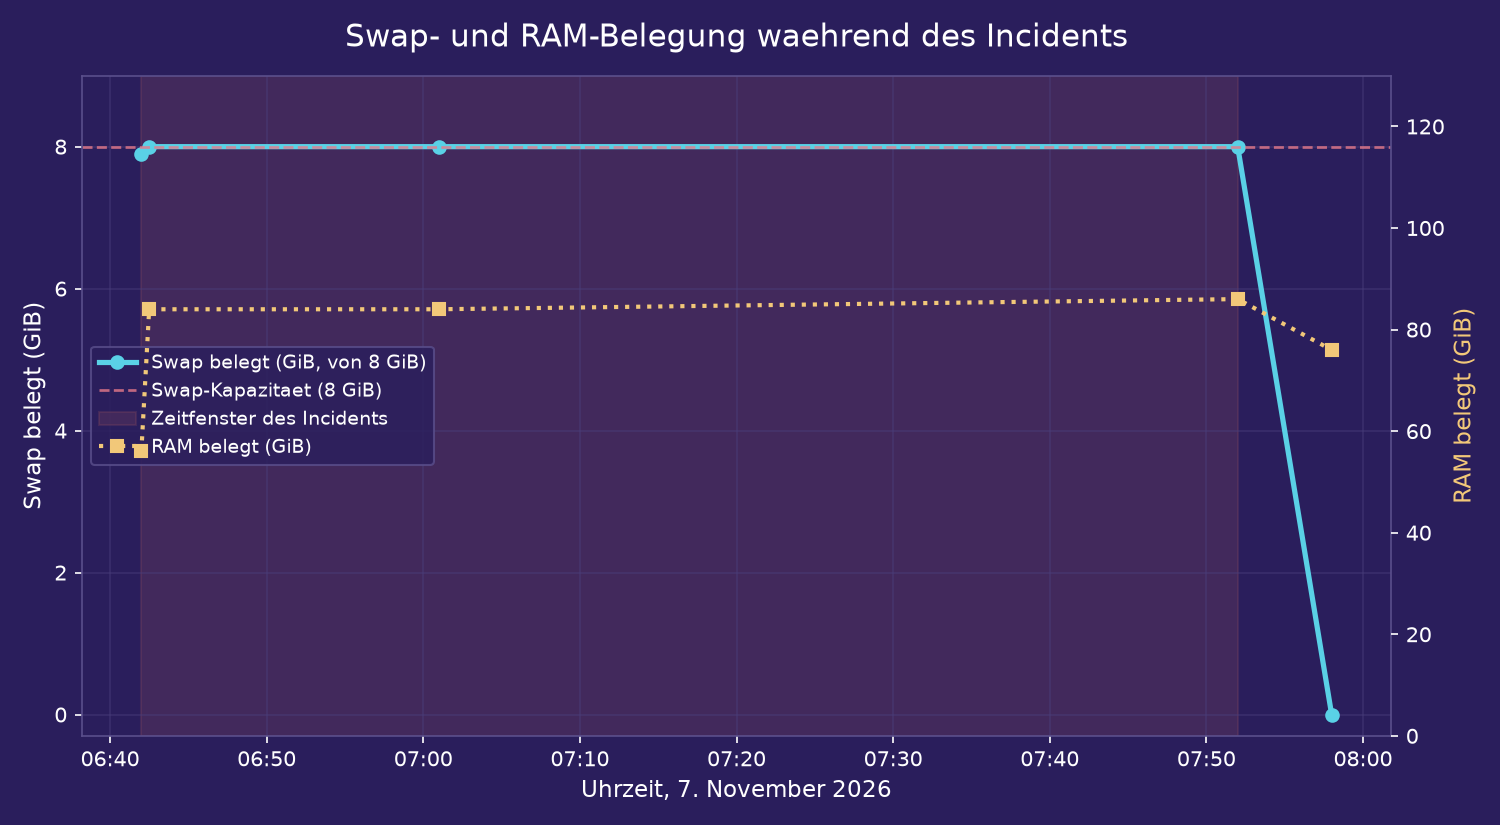
--max-context 262144 --kv-resident 32768 --resident-budget-gib 40Sofortmaßnahme (Mitigation, kein Fix): Konfiguration unter Zeitdruck verschlankt: Kontextfenster auf ein Achtel, RAM-Budget auf 40 Prozent der ursprünglichen Werte – --max-context 32768 --kv-resident 8192 --resident-budget-gib 16 (später testweise 28). Die Konfiguration war damit in Minuten angepasst – den akuten Speicherdruck selbst löste das aber nicht sofort: Swap blieb bei 8,0 von 8,0 GiB belegt, bis der Rechner rund eine Stunde später komplett neu gestartet wurde (siehe Diagramm unten). Der Fehler, den ich dabei machte, war anzunehmen, dass die reduzierte Konfiguration den Incident bereits beendet hatte, nur weil sie ihn nicht weiter verschärfte.
Die Regression, die der Vorfall hinterlassen hat
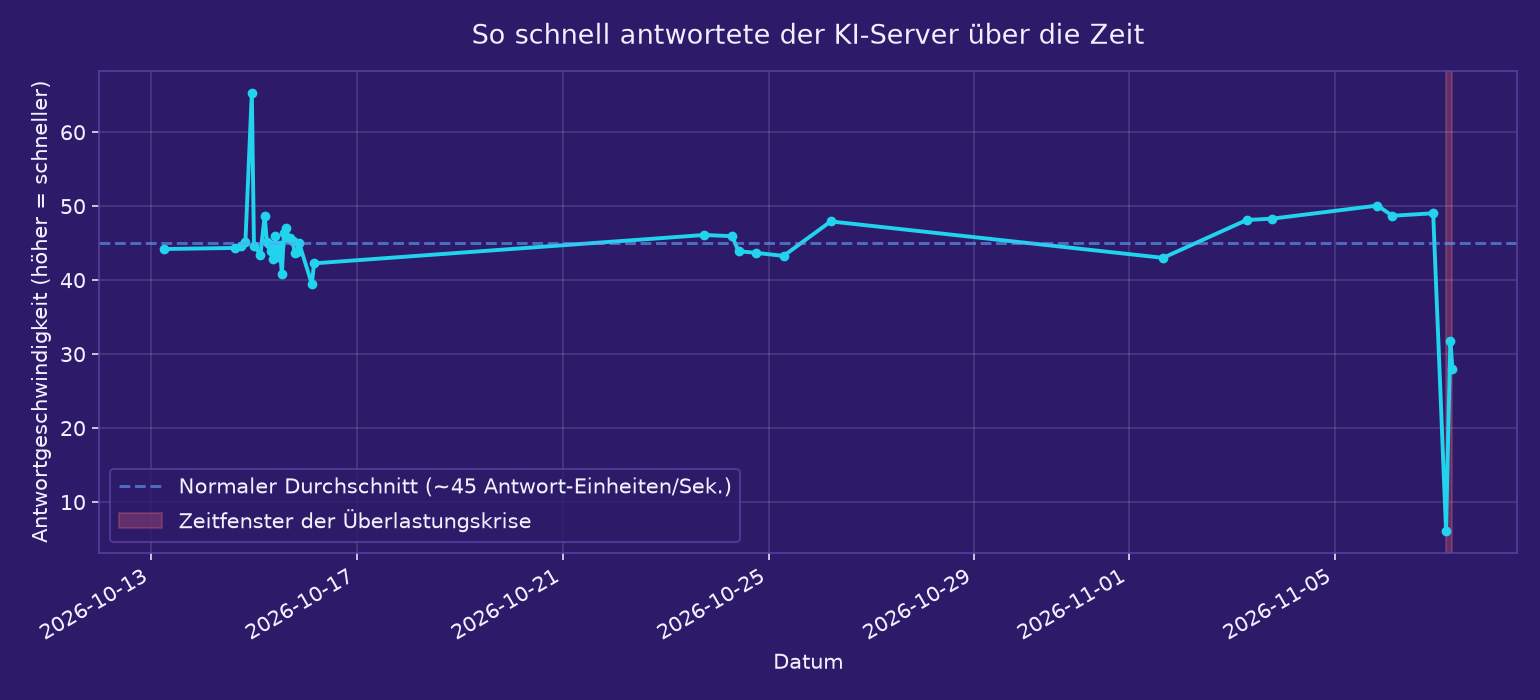
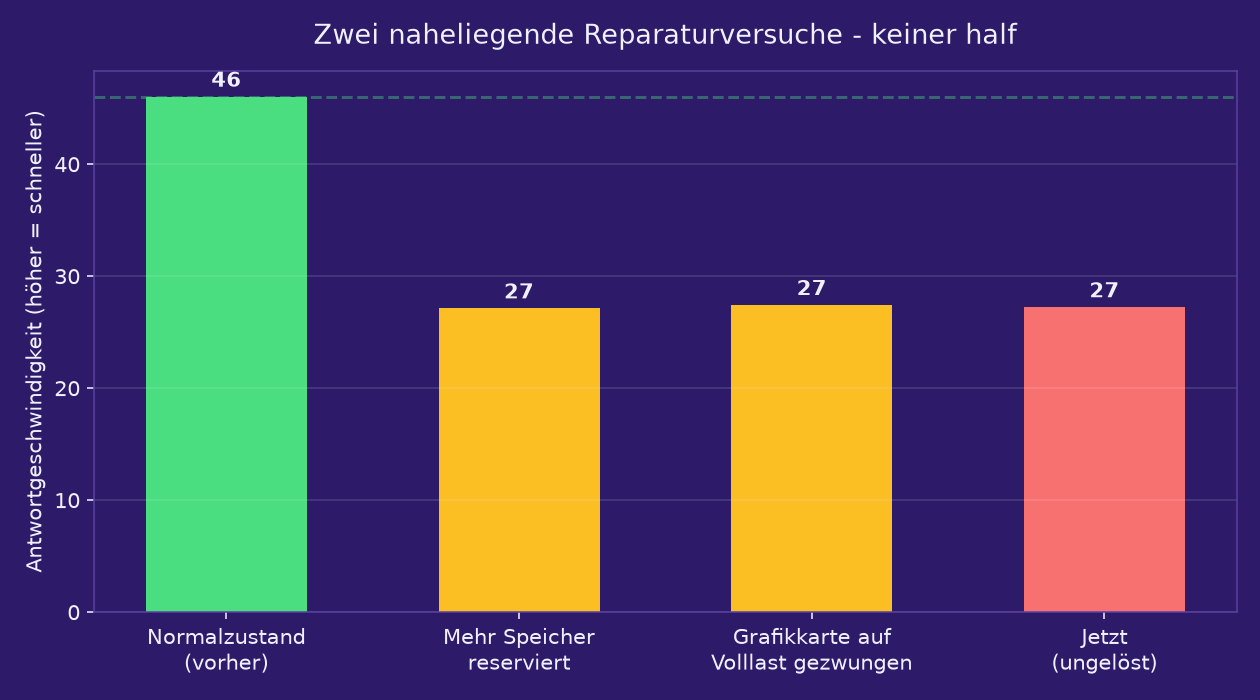
Ich erinnerte mich an frühere Durchsätze deutlich über 40 Tokens pro Sekunde. Eine erste Messung mit einem kleinen Benchmark-Script gegen die lokale OpenAI-kompatible API zeigte: nur noch 26 bis 31 Tok/s, konstant über vier Prompt-Längen (50 bis 15.000 Token Input) hinweg. Eine Performance-Regression von rund 40 Prozent, die den akuten Incident überlebt hatte.
Root-Cause-Analyse statt Trial-and-Error
Statt an Reglern zu drehen, habe ich mit meinem Hermes-Agenten die Analyse systematisch aufgezogen – Hypothesen aufstellen, einzeln testen, falsifizieren oder bestätigen, erst dann handeln.
Vier Prompt-Längen, je drei Durchläufe, Messung über usage.completion_tokens / Antwortzeit gegen /v1/chat/completions.
Hypothese: zu knappes RAM-Budget für residente Experten. resident-budget-gib von 16 auf 28 GB angehoben (+75 Prozent), Server neu gestartet, neu gemessen. Ergebnis: keine Veränderung (~27 Tok/s) – falsifiziert.
Hypothese: GPU im Sparmodus. rocm-smi zeigte die iGPU bei ~800 statt möglicher 2900 MHz, Performance-Level auf „auto“. Mit power_dpm_force_performance_level=high erzwungen, GPU lief bestätigt auf vollem Takt. Ergebnis: ebenfalls keine Veränderung – falsifiziert.
Speculative-Decoding-Trefferquote (unverändert, 60–68 % gegenüber historisch 65–75 %), GPU-Treiberfehler (dmesg sauber), CPU-Throttling (Governor „performance“), PCIe-Bandbreite (~80 GB/s, unverändert).
Historische Telemetrie statt neuer Einzelmessungen: Strata loggt bei jeder Anfrage Durchsatz und Speculative-Decoding-Details. Auswertung von 8.063 Log-Zeilen aus drei Wochen, gruppiert nach Stunde: vom 14. Oktober bis 6. November durchgehend stabil bei 43–49 Tok/s. Der Einbruch beginnt exakt am 7. November zwischen 4 und 7 Uhr – im selben Zeitfenster wie der Swap-Incident.
Reboot als Diagnoseschritt: Incident zu, Regression bleibt
Ein kompletter System-Reboot schien der sauberste nächste Schritt, um jeden möglichen Rest-Zustand im Speicher- oder Treiber-Subsystem auszuschließen. Nach dem Neustart: RAM komplett entlastet (39 GB verfügbar), Swap bei 340 KB von 8 GB – der Incident war zweifelsfrei vorbei. Der Durchsatz blieb trotzdem bei 25–30 Tok/s, mit allen 24.576 Modell-Experten bereits warmgelaufen im GPU-Cache. Das ist der entscheidende diagnostische Datenpunkt: Wenn ein sauberer Reboot ein Symptom nicht behebt, ist es kein Nachwirken des Incidents mehr – es ist eine eigenständige Ursache, meist Config Drift, der Zustand einer Konfiguration, der unter Druck entsteht und dann einfach liegen bleibt.
Eine Fehlspur dabei: Das Log zeigte resident RAM mode: 0.00 GiB of experts in RAM, 24576 in the GPU cache – kein Bug, sondern Normalverhalten dieser Unified-Memory-Hardware (AMD Strix Halo): Bei --expert-cache auto passen hier alle 24.576 Experten direkt in den GPU-Cache. resident-budget-gib greift nur, wenn Experten nicht hineinpassen – hier war der Parameter von Anfang an irrelevant, trotz naheliegender Verdächtigung.
Der tatsächliche Übeltäter: --kv-resident, der Streaming-Parameter für den Kontext-Cache zwischen GPU und gepinntem RAM. Die Engine erzwingt intern einen Mindestwert von 20.480 Zellen – der in der Notfall-Config auf 8.192 reduzierte Wert wurde also faktisch auf 20.480 hochgezogen und erzeugte dadurch mehr Streaming-Overhead pro Token als der alte, höhere Wert von 32.768.
Fix: Config Drift zurückrollen, nicht neu raten
Mit wieder ausreichend freiem Speicher (37 GB verfügbar, kein konkurrierender Prozessstart mehr) habe ich die drei unter Druck reduzierten Parameter gezielt zurückgerollt – kein neues Experiment, sondern ein kontrolliertes Rollback auf den zuletzt bekannten guten Zustand, mit Monitoring während des gesamten Ladevorgangs.
| Parameter | Notfall-Config (Incident-Response) | Zurückgerollt (Fix) |
|---|---|---|
--max-context |
32.768 | 262.144 |
--kv-resident |
8.192 | 32.768 |
--resident-budget-gib |
28 | 40 |
RAM/Swap blieben während des gesamten Rollbacks stabil (Swap unter 250 MB von 8 GB) – keine Wiederholung des ursprünglichen Incidents. Der Durchsatz liegt wieder nahe an der historischen Baseline von 43–49 Tok/s, beim mittleren Szenario sogar mittendrin.
Nachtrag: Hat die BIOS-Änderung am VRAM etwas gebracht?
Die zweite Maßnahme entstand direkt aus derselben Krise, nur auf einem Nebengleis: Beim GPU-Speichercheck während der akuten Swap-Überlastung (rocm-smi, derselbe Befehl, mit dem ich später den GPU-Takt prüfte) fiel auf, dass von den 16 GiB fest im BIOS reserviertem dediziertem Grafikspeicher nur rund 1,1 GiB tatsächlich genutzt wurden – der Rest stand dem System nicht als RAM zur Verfügung, obwohl er dort gerade dringend gefehlt hätte. Mein Hermes-Agent und ich empfahlen deshalb noch vor dem geplanten Reboot, diese BIOS-Reservierung von 16 auf 8 GiB zu verkleinern, um den ungenutzten Speicher freizugeben. Die Änderung wurde beim Reboot direkt im BIOS umgesetzt – zusätzlich zum eigentlichen Incident-Thema dieses Artikels, aber am selben Abend entschieden.
Bestätigt per rocm-smi und free -h: Der VRAM-Total-Wert steht jetzt auf 8 statt 16 GiB, und das nutzbare System-RAM ist seit dem Reboot bei 115 statt vorher 107 GiB – exakt die erwarteten 8 GiB mehr, kein Rundungsfehler, keine Nebenwirkung auf die GPU-Leistung in den Benchmarks oben.
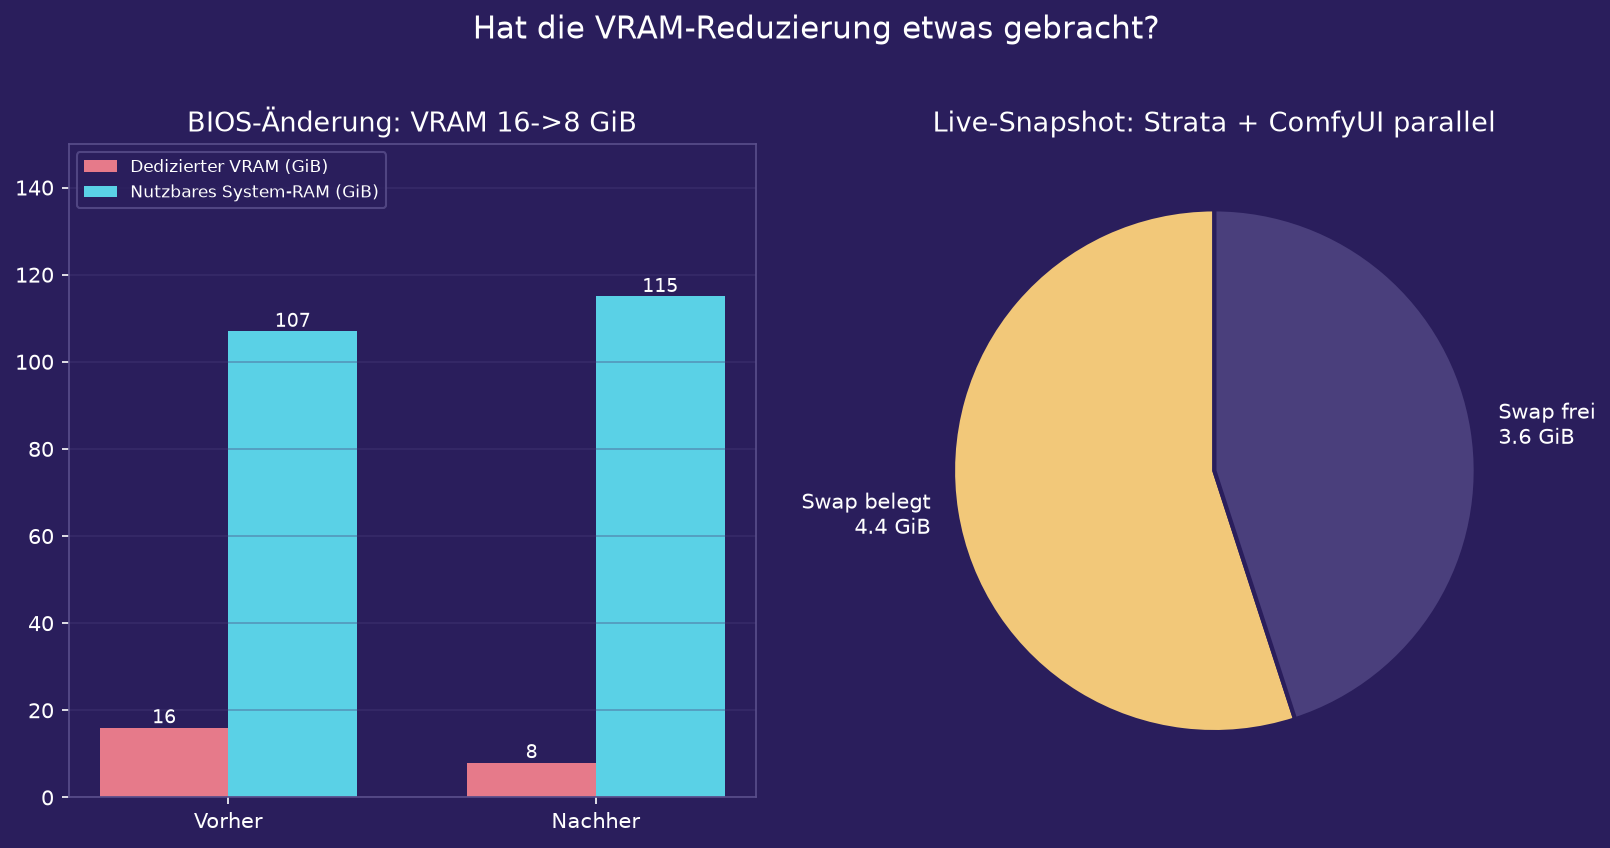
Meine Einschätzung: Die Maßnahme war richtig und hat exakt das gehalten, was die Datenlage versprach – acht GiB mehr nutzbarer Speicher, ohne messbaren Nachteil. Sie ist aber kein Freibrief für beliebig viele parallele Workloads. Der aktuelle Snapshot mit 4,4 von 8 GiB belegtem Swap bei gleichzeitigem Strata- und ComfyUI-Betrieb zeigt, dass der gewonnene Spielraum unter echter Last schnell wieder aufgebraucht ist – noch kein Incident, Load Average ist unauffällig, aber ein klares Frühwarnsignal. Die eigentliche Lehre aus dem ersten Incident bleibt also bestehen: Mehrere speicherhungrige Dienste gleichzeitig zu starten, ist der eigentliche Risikofaktor, unabhängig davon, wie viel zusätzlicher Spielraum die BIOS-Änderung geschaffen hat.
Nachgemessen (10.11., nach gut 3 Tagen Laufzeit seit dem Reboot): Kein einziger OOM-Kill im gesamten Kernel-Log seit dem Boot – nicht nur in den ersten Stunden, sondern über den vollen Beobachtungszeitraum von inzwischen gut 73 Stunden. Genau das Szenario, das im ursprünglichen Incident zum Abbruch führte – der Assistent wurde vom Kernel wegen Speichermangel beendet –, ist seitdem kein einziges Mal wieder aufgetreten, trotz mehrerer gleichzeitig laufender Agenten-Prozesse auf derselben Maschine. Der Speicherdruck selbst ist dabei unverändert hoch: Der Swap liegt aktuell bei 7,7 von 8 GiB, also fast vollständig ausgelastet. Das ist der eigentliche Stabilitätsbeweis für die BIOS-Änderung: nicht, dass der Speicherdruck verschwunden wäre, sondern dass er auch nach mehreren Tagen Dauerbetrieb nicht in eine Katastrophe gekippt ist. Krise verhindert, nicht Problem vollständig gelöst – aber genau das war der Anspruch.
Bemerkenswert an dieser Nachmessung: Die eigentliche Frage – ob die Änderung die Stabilität verbessert hat, nicht nur die Geschwindigkeit – kam nicht von meinem Agenten, sondern von mir selbst. Nach 15 Jahren Erfahrung mit genau solchen Systemen reichte mir die erste Antwort (Tokens pro Sekunde) nicht, ich musste nachfragen und den Agenten auf die eigentliche Fragestellung zurückholen. Die Verifikation selbst – Kernel-Log, Journal, Speicherstatistik, alles zusammen eingeordnet – hat dann mit Mensch und KI zusammen nur eine gute halbe Stunde gedauert.
Fazit
Die ursprüngliche Diagnose war nur zur Hälfte richtig: Der akute Incident – die Swap-Überlastung selbst – war bereits mit dem Reboot erledigt. Die tatsächliche Ursache der Performance-Regression war etwas anderes: eine Notfall-Konfiguration, unter Zeitdruck in Minuten zusammengebaut, die sich selbständig gemacht hatte und zum stillen Dauerschaden wurde, lange nachdem der auslösende Vorfall behoben war. Ein Reboot kann den Prozess-Zustand zurücksetzen, aber keine Konfigurationsdatei korrigieren, die man selbst verändert hat. Die eigentliche Lehre ist deshalb nicht „Swap-Überlastungen sind gefährlich“ – das war ohnehin klar –, sondern: Jede Notfall-Konfiguration, die unter Druck entsteht, braucht einen zweiten, bewussten Blick, sobald der Druck weg ist, sonst wird aus einer befristeten Mitigation lautlos ein dauerhafter Performance-Verlust.
- Strata-Server-Log
strata-unsloth-ud-iq4_xs.log, 8.063 ausgewertete Einträge, 14.10.–07.11.2026 - Lokales Prometheus-Monitoring mit Custom-GPU-Textfile-Collector
- Lokal oder Cloud? Was zehn Tage KI-Agenten-Betrieb uns über Kosten und Grenzen gelehrt haben – derselbe Rechner, dieselbe Strata-Installation, mehr Hintergrund zum Setup
- AMD-ROCm-SMI-Dokumentation – für den GPU-Takt-Check verwendetes Tool