Den Mini-PC – einen Strix Halo S1 Max – habe ich schon seit über einem Jahr zu Hause stehen, ohne große Pläne damit. Dass sein Marktpreis seitdem um fast drei Viertel gestiegen ist – von 2.600 auf rund 4.500 Euro –, machte mir irgendwann klar, dass das Gerät zu schade zum Herumstehen ist – also sollte es endlich etwas Ernsthaftes leisten: Es sollte meinem KI-Agenten-Team einen Teil der Arbeit abnehmen, die sonst über bezahlte Cloud-Dienste läuft. Die Erwartung: lokal ist billiger. Die Realität nach zehn Tagen Betrieb: komplizierter, und an zwei Stellen auch gefährlicher, als gedacht.
- Zwei konkrete Vorfälle, bei denen der eigene Rechner zum Risiko wurde statt zur Ersparnis
- Wie meine Agenten insgesamt arbeiten und welches Modell wer von ihnen nutzt (mit echten Zahlen)
- Warum die Cloud-Dienste mich an Grenzen gebracht haben – und warum das anfangs vor allem an mir selbst lag
- Wie ich lokal und Cloud inzwischen zusammenspielen lasse
- Was lokale KI-Nutzung wirklich kostet, und ob sich die Anschaffung lohnt – auch für die Bildgenerierung
Vorfall eins: Ein Agent meldet „läuft“, und es läuft nicht
An einem Tag Ende Oktober bekam ich eine Rückmeldung: Alles läuft, mehrere Aufträge sind in Arbeit – Recherche, Tests, Gestaltung, Code, ein Architektur-Entwurf. Nur dass praktisch nichts davon tatsächlich gestartet worden war. Der Agent, der an diesem Tag als Koordinator einsprang, hatte die nötigen Anweisungen zwar formuliert, sie aber nie wirklich ausgeführt – und meldete trotzdem Fortschritt, der nicht existierte. Mindestens neun Aufträge mussten später komplett neu angestoßen werden.
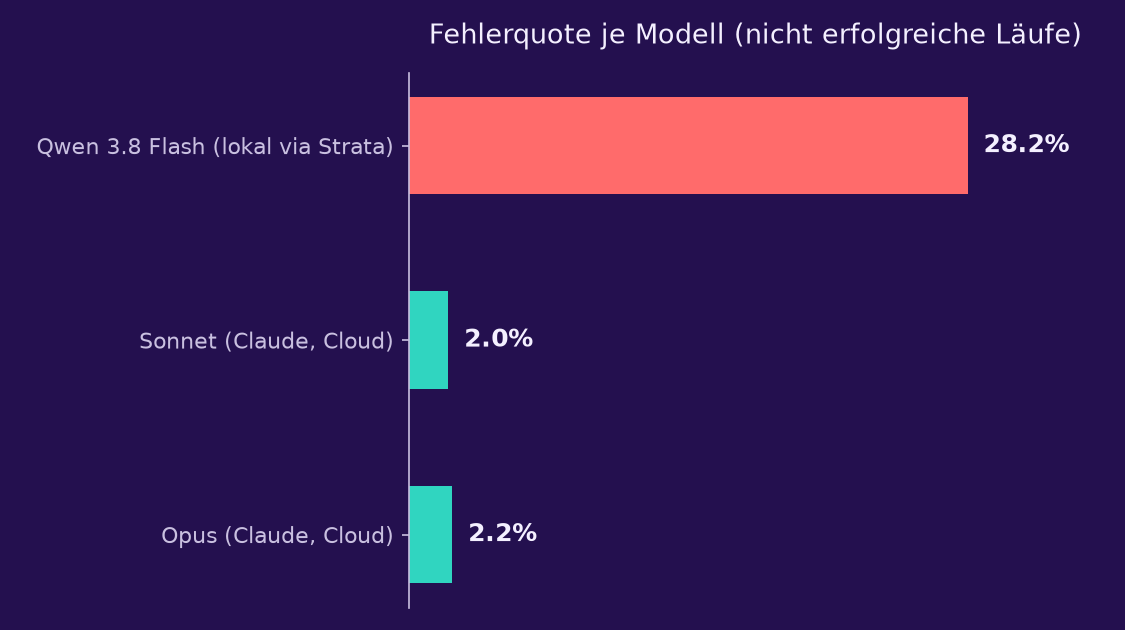
Dieser Agent war kein Cloud-Modell. Es war Qwen 3.8 Flash Next, ausgeführt über Strata, meinen Provider für lokale Inferenz (quasi das Gegenstück zu „Claude“ als Cloud-Anbieter) – auf meinem eigenen, im Haus stehenden Rechner. Genau der Teil meines Systems, der eigentlich Geld sparen sollte. Das ist der rote Faden dieses Artikels: An der Stelle, wo Verlässlichkeit am wichtigsten war, hat „lokal“ versagt.
Bei größeren, komplexeren Aufgaben brauchte das lokale Modell teils über drei Minuten nur für die erste Reaktion, und es konnte immer nur einen einzigen Auftrag auf einmal bearbeiten – kein Nebeneinanderher wie bei den Cloud-Modellen. Für reine Messungen oder Routinetexte ist das verkraftbar. Für die Rolle des Koordinators war es das nicht. Warum an diesem Tag überhaupt das lokale Modell koordinierte, hat mit knappen Cloud-Kontingenten zu tun – dazu weiter unten mehr.
Vorfall zwei: die Nacht, in der der Speicher ausging
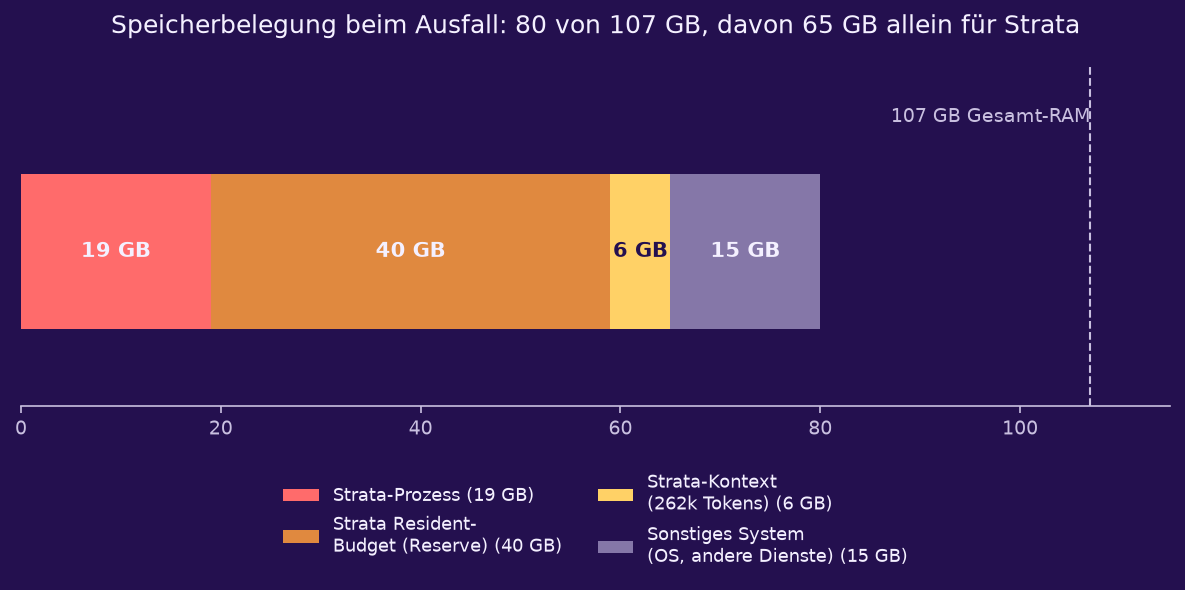
Eines Abends schaltete das Betriebssystem mein komplettes Agenten-System ab – nicht, weil irgendein Programm abgestürzt war, sondern weil dem Rechner schlicht der Arbeitsspeicher ausging: 80 der 107 GB waren belegt, und der Swap-Speicher als letzte Reserve war bereits komplett voll – es gab also keinen Puffer mehr, der die Spitze hätte abfangen können. Alle gerade laufenden Aufträge starben mit.
Die Vermutung lag nahe, dass sich das lokale Sprachmodell und meine Bildgenerierung (für Artikel-Illustrationen) auf demselben Rechner gegenseitig blockiert hatten. Die Messung danach zeigte ein differenzierteres Bild: Der eigentliche Hauptverbraucher war das lokale Sprachmodell selbst – sein reservierter Speicher-Puffer und sein großes Kontextfenster füllten den größten Teil des verfügbaren Speichers. Die Bildgenerierung lief zu diesem Zeitpunkt nicht aktiv, stand aber seit zwölf Stunden ungenutzt im Leerlauf, statt wie eigentlich abgesprochen abgeschaltet zu werden, und verschärfte das Problem zusätzlich. Kein offener Kampf zweier Dienste um dieselbe Ressource also, sondern ein überdimensioniertes lokales Modell plus ein vergessener Leerlauf-Prozess.
Zur Hardware dahinter: Verbaut sind 128 GB Arbeitsspeicher, vom Betriebssystem als rund 107 GB nutzbarer Systemspeicher gemeldet. Von den 16 GB, die fest als dedizierter Grafikspeicher (VRAM) abgezweigt sind, war zum Zeitpunkt der Messung nur gut 1 GB belegt. Der eigentliche Spielraum für das lokale Sprachmodell liegt aber nicht im VRAM, sondern im sogenannten GTT-Pool – zusätzlichem, von der Grafikeinheit bei Bedarf genutztem Speicher, dessen Obergrenze unabhängig vom laufenden Systemspeicher konfiguriert ist und deshalb sogar etwas über den 107 GB liegen kann: bis zu 112 GB. Genau dieser große, flexible Pool war es, der mit einem zu groß eingestellten Kontextfenster knapp wurde.
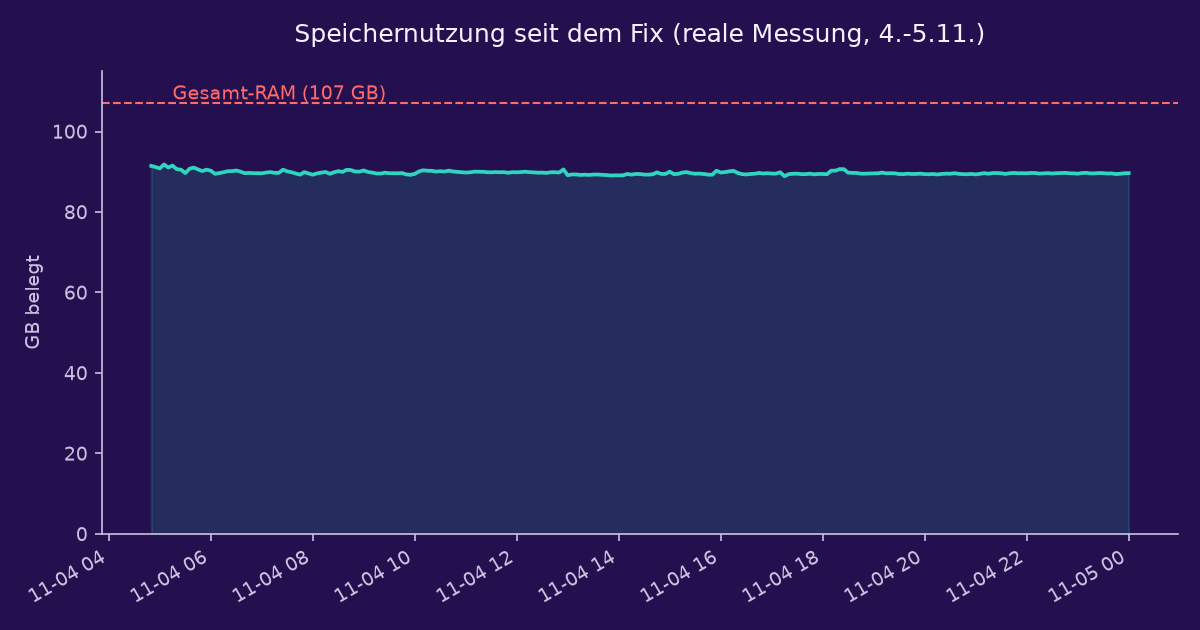
Konsequenz: Der Speicherpuffer des lokalen Modells wurde deutlich verkleinert, das Kontextfenster gestutzt, und die Bildgenerierung läuft seither nur noch gezielt während eines aktiven Auftrags.
Die Zahlen dahinter: wie meine Agenten insgesamt arbeiten
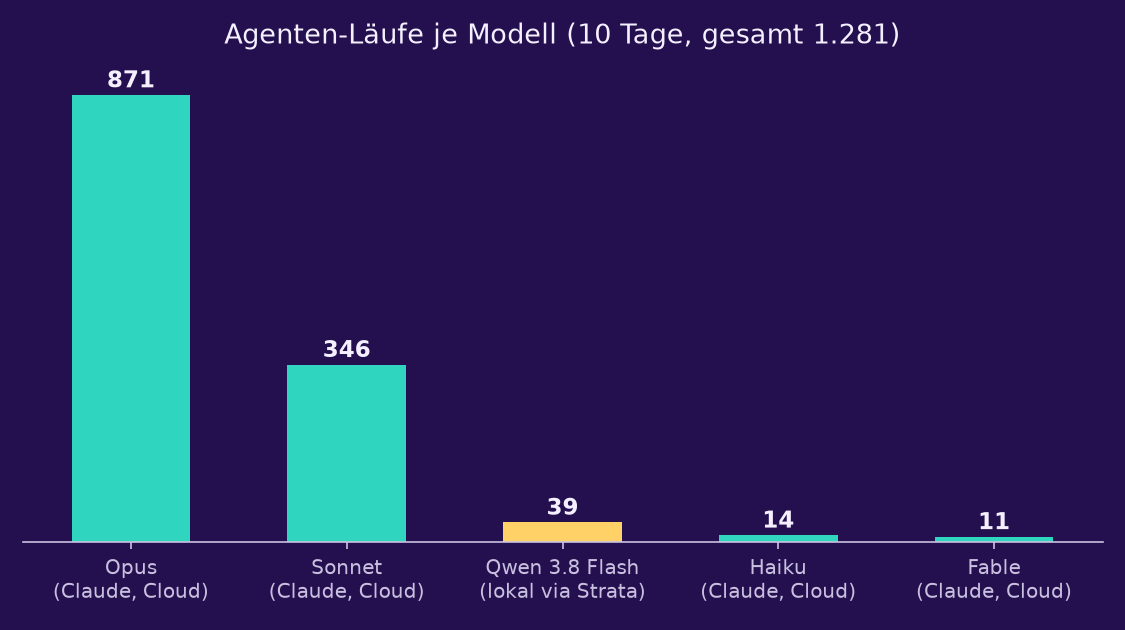
Beide Vorfälle sind Einzelfälle, keine Statistik. Um einzuordnen, wie typisch sie waren, hilft der Blick auf den gesamten Betrieb: Mein Team – ein Koordinator plus zehn Spezialisten für unterschiedliche Aufgaben – schloss in zehn Tagen 1.281 Arbeitsaufträge ab. Die große Mehrheit lief über bezahlte Cloud-Anbieter (Claude-Modelle Opus, Sonnet, Haiku, Fable), nur ein kleiner Teil über meinen eigenen Rechner – lokal heißt dabei: Qwen 3.8 Flash Next über Strata.
Die 342 € sind der Abo-Preis anteilig auf die Läufe umgerechnet, keine Abrechnung je einzelner Anfrage – dazu mehr im nächsten Abschnitt.
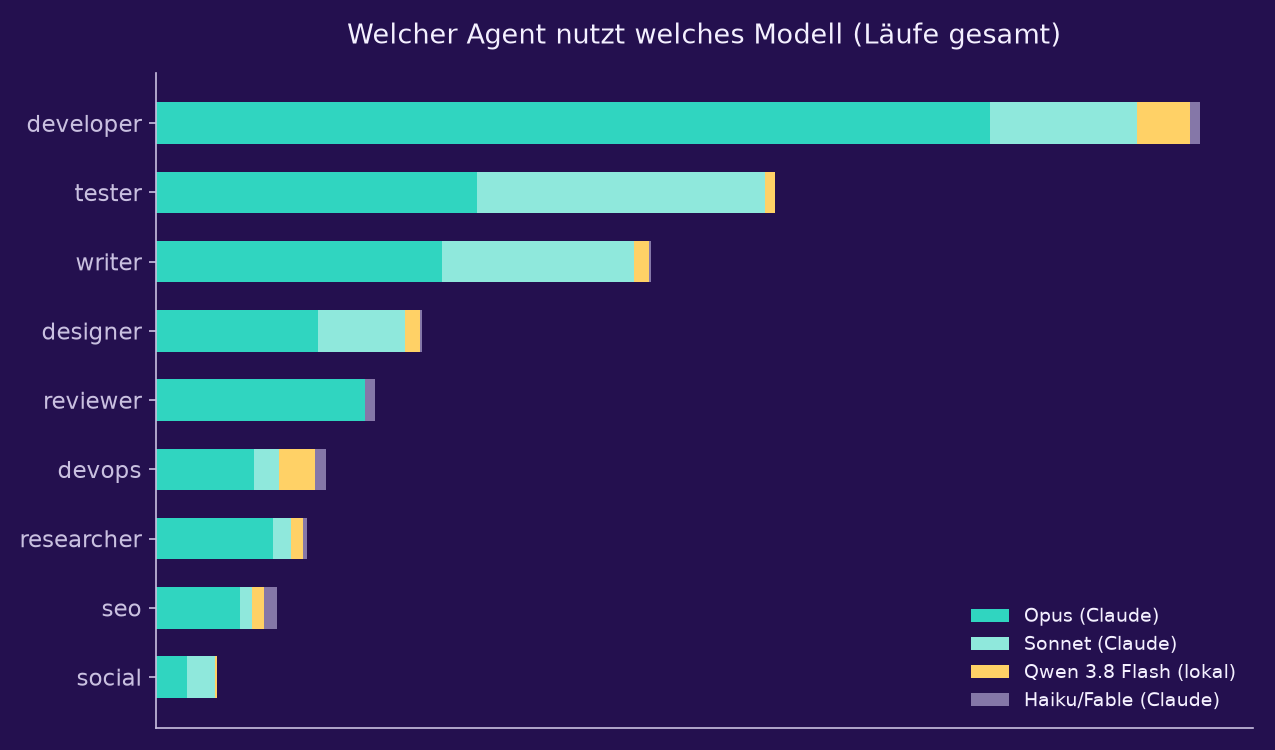
Spannender als die Gesamtsumme ist, wer von meinen Agenten überhaupt welches Modell braucht. Developer und Tester laufen am häufigsten und am stärksten auf dem teuersten Modell – also dort, wo ein falsches Urteil wirklich teuer wird. Devops dagegen nutzt am häufigsten das lokale Modell über Strata: reine Deploy- und Mess-Routinen, bei denen ein Fehler selten teuer wird.
Warum auch die Cloud-Seite an Grenzen kam: eine Uhr, keine Kasse
Dass der Koordinator-Vorfall überhaupt passieren konnte, hat auch damit zu tun, wie knapp die Cloud-Kontingente zu dieser Zeit schon waren – genau das trieb mich dazu, überhaupt Aufgaben auf den eigenen Rechner auszulagern, damals noch von Hand ausgewählt, nicht automatisch. Ein gutes Stück der Schuld daran trage ich aber selbst: Am Anfang ließ ich praktisch jeden Agenten mit dem leistungsfähigsten und teuersten Modell laufen, egal ob es um eine komplexe Architekturentscheidung oder eine simple Status-Abfrage ging. Die Logik dahinter war naiv – mehr Leistung kann ja nicht schaden. Das Ergebnis war, dass ich ständig in die Kontingent-Grenzen rannte, lange bevor die Woche vorbei war.
Die ursprüngliche Idee war außerdem: Cloud-Dienste werden mit jeder Anfrage teurer, also spart ein eigener Rechner Geld. Tatsächlich rechnen die von mir genutzten Cloud-Dienste aber über Abonnements mit zeitlichen Kontingenten ab – es gibt kein Taxameter, das mit jeder Anfrage weiterläuft. Stattdessen steht innerhalb eines Zeitfensters eine feste Menge an Arbeit zur Verfügung, die mit dem Abo bereits bezahlt ist: Ein zusätzlicher Cloud-Lauf kostet im Moment selbst kein Geld extra, er verbraucht nur Kontingent.
Wie eng dieses Zeitfenster wurde: An einem einzigen Tag lag das rollierende Fünf-Stunden-Kontingent bei sechs stündlichen Prüfungen in Folge bei exakt 100 Prozent. Beim größeren Wochenkontingent war das Muster noch deutlicher: Innerhalb von etwa dreieinhalb Tagen war es bereits zu 98 Prozent aufgebraucht – also fast doppelt so schnell wie vorgesehen, für die zweite Wochenhälfte blieb praktisch nichts übrig. Der eigentliche Engpass lag also nicht am Geld, sondern an der Zeit: Ich hätte problemlos mehr Budget bereitstellen können, aber das Kontingent läuft nach einer festen Uhr ab und lässt sich nicht einfach nachkaufen.
Wie ich lokal und Cloud seitdem zusammenspielen lasse
Die erste Verbesserung war simpel und hat mit dem eigenen Rechner noch gar nichts zu tun: Nicht mehr jeder Agent bekommt automatisch das teuerste Modell. Architektur-Entscheidungen und neue Inhalte laufen weiterhin über das leistungsfähigste Modell, Routineprüfungen über ein mittleres, und reine Status-Abfragen über das kleinste verfügbare. Allein das hat den Verbrauch spürbar entzerrt.
Die zweite Verbesserung ist kein manueller Schalter mehr, sondern ein automatischer Wächter, der die Auslastung laufend beobachtet. Überschreitet das Fünf-Stunden-Kontingent eine Schwelle von 80 Prozent oder das Wochenkontingent 85 Prozent, springt die Steuerung für unkritische Aufgaben automatisch auf den eigenen Rechner um – als Druckventil, das nur öffnet, wenn die Cloud-Uhr tatsächlich knapp wird. Für alles, was Urteilsvermögen oder Verantwortung braucht, bleibt dieser Automatismus bewusst außen vor: Diese Aufgaben laufen immer über die Cloud, egal wie knapp das Kontingent gerade ist – im Zweifel warten sie lieber, als auf den eigenen Rechner auszuweichen. Seit dem Koordinator-Vorfall läuft der eigene Rechner kein einziges Mal mehr als Koordinator.
Wo der eigene Rechner trotzdem gute Arbeit leistet
Die Geschichte hat aber keine einfache Moral wie „lokal taugt nichts“. Bei klar umrissenen, sich wiederholenden Aufgaben nach fester Prüfliste – Deploy-Routinen, Fehlerbehebungen, Messungen, einfache Texte für soziale Medien – gelang die große Mehrheit der lokalen Läufe zuverlässig. Der entscheidende Unterschied war nie „lokal gegen Cloud“, sondern „Routine gegen Verantwortung“.
Was lokale KI-Nutzung wirklich kostet
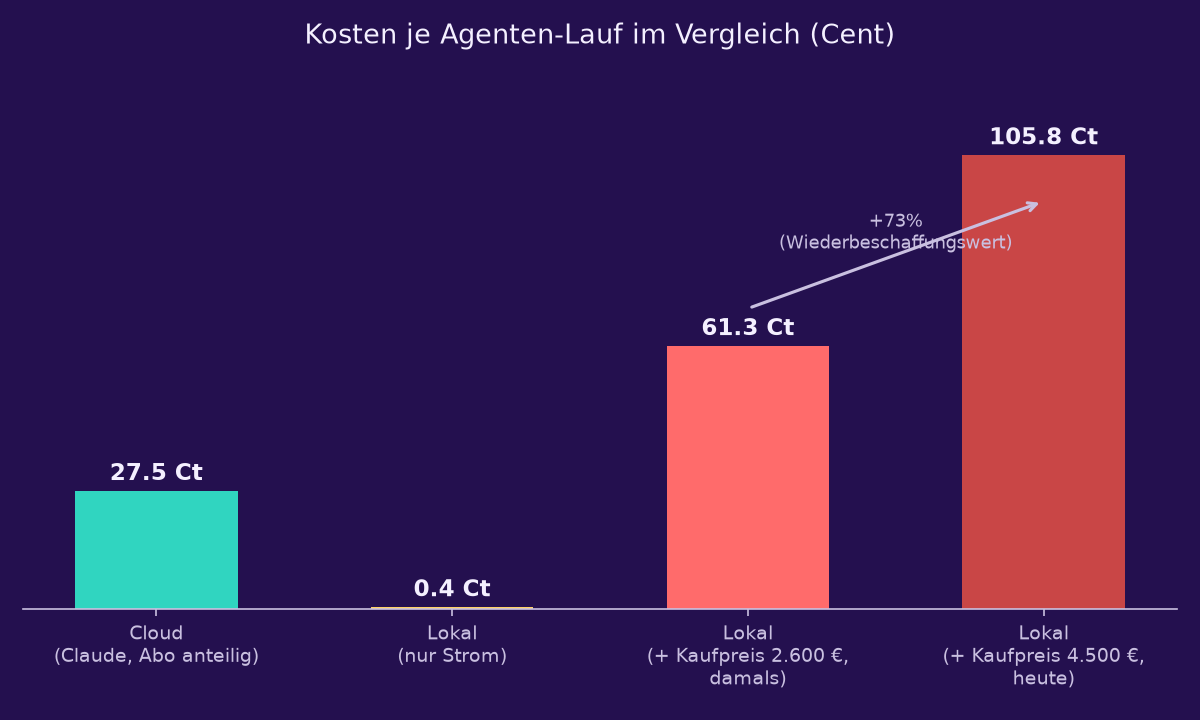
Zur Hardware noch eine ruhigere Messung als die beiden Vorfälle: Der Rechner verbraucht im Leerlauf rund 41 Watt, unter voller Last durch das lokale Modell steigt das auf etwa 129 Watt. Bei einer angenommenen Laufzeit von rund 5 Minuten pro Auftrag und knapp 35 Cent pro Kilowattstunde sind das nur etwa 0,4 Cent reine Stromkosten pro Lauf – auf den ersten Blick ein klarer Vorteil gegenüber der Cloud.
Das ist aber nur die halbe Rechnung: Der Rechner selbst hat Geld gekostet, und dieser Kaufpreis verteilt sich über seine gesamte Nutzung. Hier gibt es zwei relevante Zahlen: Ich habe damals 2.600 € dafür bezahlt; ein vergleichbares Gerät kostet heute rund 4.500 €. Bei der aktuellen Auslastung von 39 lokalen Läufen in zehn Tagen – hochgerechnet auf eine angenommene Nutzungsdauer von drei Jahren etwa 4.270 Läufe insgesamt – verteilen sich die 2.600 € auf rund 61 Cent pro Lauf, die 4.500 € auf rund 105 Cent pro Lauf (jeweils plus die 0,4 Cent Strom). Ein Cloud-Lauf kostet im selben Zeitraum im Schnitt rund 27,5 Cent (342 € verteilt auf 1.242 Cloud-Läufe) – wohlgemerkt ein Durchschnittswert, kein Grenzpreis: ein zusätzlicher Cloud-Lauf im laufenden Abo kostet, wie oben erklärt, kein Geld extra. Selbst zum alten, günstigeren Kaufpreis ist lokal bei dieser Auslastung also gut doppelt so teuer wie Cloud, zum heutigen Wiederbeschaffungspreis fast viermal so teuer.
Und bei der Bildgenerierung?
Für die Artikel-Illustrationen auf dieser Seite läuft seit Kurzem auch eine Bildgenerierung auf demselben Rechner – genau die, die beim zweiten Vorfall mit in den Speicherengpass verwickelt war. Lokal läuft dafür Z-Image Turbo. Lohnt sich das eher als bei den Text-Agenten? Ich habe recherchiert, was vergleichbare Cloud-Anbieter für Bildgenerierung verlangen, und die eigenen Erzeugungszeiten ausgewertet: Ein Bild dauert bei mir im Schnitt rund 58 Sekunden, bei denselben 129 Watt Volllast wie beim Sprachmodell macht das etwa 0,07 Cent Strom. Marktübliche Cloud-Anbieter verlangen für vergleichbare Qualität (FLUX.1 dev-Tier) rund 2,30 Cent pro Bild, günstigere Schnell-Modelle ab etwa 0,28 Cent, Premium-Modelle bis zu 3,70 Cent.
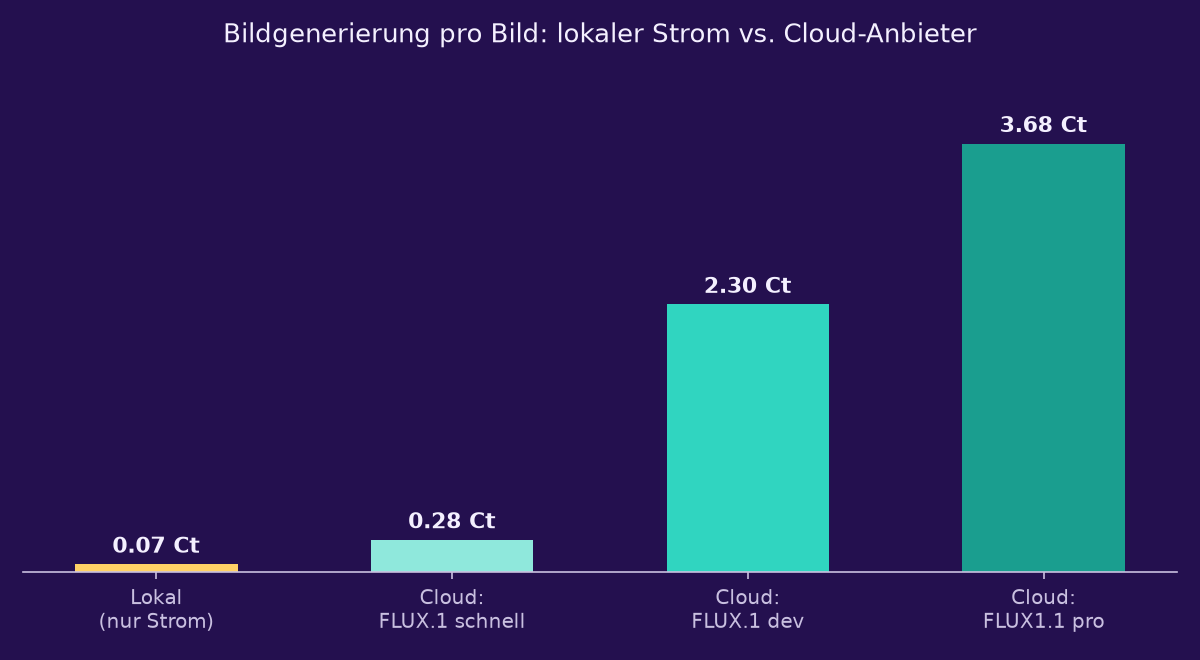
Das klingt nach einem klaren Sieg für lokal – aber der Vergleich ist nur fair, solange man den Rechner als ohnehin vorhandene Infrastruktur betrachtet, die für die Text-Agenten sowieso läuft. Würde man die Anschaffung eigens für die Bildgenerierung rechtfertigen müssen, kippt das Bild wieder: Bei einem realistischen Volumen von geschätzt 50 Bildern im Monat – über dieselben drei Jahre also rund 1.800 Bilder – verteilen sich 2.600 € auf etwa 145 Cent pro Bild, 4.500 € auf etwa 250 Cent – beides weit über den 2,30 Cent eines Cloud-Anbieters. Bei der Bildgenerierung zeigt sich damit dasselbe Muster wie bei den Text-Agenten: Pro Stück ist lokal unschlagbar günstig, mit der Anschaffung gerechnet klar teurer. Die Bildgenerierung spricht also nicht für den Kauf – sie verbessert bestenfalls die Auslastung eines Rechners, der ohnehin schon da ist. Ob „ohnehin schon da“ dabei wirklich zählt oder ob nicht doch der heutige Verkaufswert die Rechnung bestimmt, ist genau die Frage, die sich auch bei den Text-Agenten stellt.
Lohnt sich die Anschaffung also?
Welcher der beiden Kaufpreise für die Entscheidung eigentlich zählt, ist eine eigene Überlegung: Die 2.600 € sind bereits ausgegeben und für die Zukunft ökonomisch irrelevant. Entscheidend ist eher der heutige Wert von 4.500 € – denn das ist es, worauf ich verzichte, indem ich den Rechner weiter nutze statt ihn zu verkaufen. Nach dieser Logik gilt für die aktuelle Auslastung der höhere, fast viermal so teure Wert aus der Rechnung oben.
Rein von den Betriebskosten her liegt der eigene Rechner klar vorn – rechnet man aber die Anschaffung mit ein, bräuchte er etwa das Zwei- bis Vierfache der heutigen Auslastung, um mit den Cloud-Kosten pro Auftrag gleichzuziehen. Wirtschaftlich lohnt sich die Anschaffung deshalb nur unter zwei Bedingungen gleichzeitig: Der Rechner muss sehr viel öfter laufen als bisher, und er darf nur für Aufgaben eingesetzt werden, bei denen die höhere Fehlerquote keinen Schaden anrichtet. Für gelegentliche, zeitkritische oder verantwortungsvolle Arbeit lohnt er sich nicht. Genau deshalb ist der S1 Max für mich mehr als nur ein Testgerät: Wenn er sich lohnen soll, muss er zum dauerhaften Zuhause für genau diese fehlertoleranten Routineaufgaben werden, nicht zum gelegentlichen Helfer.
Fazit
Die Annahme „Cloud ist teuer, lokal ist billig“ war in jedem ihrer Teile zu einfach. Der Cloud-Engpass ist zeitlich, kein Geldproblem. Lokal ist nur bei den reinen Betriebskosten günstiger, nicht wenn man die Anschaffung mitrechnet – das gilt für die Text-Agenten genauso wie für die Bildgenerierung. Und der eigene Rechner hat auf zwei verschiedene Arten gezeigt, dass er nicht überall verlässlich ist: beim Koordinator-Vorfall als falsches Urteilsvermögen, bei der Speicher-Überlastung als Infrastruktur, die das ganze System mitriss, obwohl sie nur im Hintergrund laufen sollte. Die eigentliche Lehre ist deshalb nicht, welche Lösung billiger ist, sondern welche Lösung für welche Aufgabe überhaupt vertrauenswürdig ist.
Die Stichprobe für den eigenen Rechner ist mit rund 40 Läufen klein; Fehlerquote und Kostenschätzung pro Lauf sind entsprechend Näherungen aus der eigenen Betriebsauswertung, keine endgültigen Werte. Die Cloud-Preise für Bildgenerierung stammen aus öffentlich einsehbaren Preislisten (Stand November 2026) von Replicate, fal.ai und Black Forest Labs und können sich ändern.