Nachts, wenn meine Agenten Pause haben, trainiere ich ein LoRA. Klingt nach Technik-Kauderwelsch, ist aber im Kern simpel: Ich bringe einem KI-Bildmodell etwas bei, das es vorher nicht konnte. In diesem Artikel erzähle ich, wie das bei mir konkret abläuft – mit echten Zahlen aus echten Trainingsnächten, nicht aus der Theorie.
Worum es geht:
- Was ein LoRA ist und warum ich dafür nicht das ganze KI-Modell neu trainieren muss
- Wie mein Keto-Pizza-Bilderproblem entstand und wie ich es gelöst habe
- Warum das Training nachts läuft und wie ich mir die Grafikkarte mit meinem KI-Assistenten teile
- Mein zweites LoRA-Projekt: ein LoRA von meinem eigenen Gesicht – und was ich dabei über Lizenzen gelernt habe
Das Problem: Meine Keto-Pizza sah aus wie vom Italiener
Seit ich meine Firma so aufgestellt habe, dass KI-Agenten einen Großteil der Arbeit erledigen (mehr dazu in Mein Passierschein A38), erzeugen sie auch die Bilder für mein Keto-Kochbuch – und genau dabei ist mir ein Ärger aufgefallen. Bei der Durchsicht der Rezeptbilder ist mir aufgefallen: Elf Brot- und Pizza-Bilder im Buch (und zwölf auf der zugehörigen Rezept-Website ketovavaria.de) sahen aus wie normales Weizengebäck – luftige Krume, dicker aufgegangener Rand, glatte goldbraune Kruste. Genau das Gegenteil von Keto. Echte Keto-Pizza hat einen dünnen, körnigen Boden aus Mandel-, Kokos- oder Blumenkohlmehl, die Krume ist dicht und etwas feucht. Das KI-Modell kannte diesen Unterschied einfach nicht – es hatte in seinem Training viel mehr „normale“ Pizza gesehen als Keto-Pizza.
Die Lösung heißt nicht „neues Modell trainieren“ (das würde Wochen dauern und wäre für mich unbezahlbar), sondern: ein LoRA.
Was ist ein LoRA eigentlich?
Ein LoRA (Low-Rank Adaptation) ist ein kleines Zusatzmodul, das man über ein bestehendes KI-Modell legt. Statt das riesige Basismodell komplett neu zu trainieren, trainiert man nur dieses kleine Modul – es lernt die Besonderheiten eines bestimmten Motivs oder Stils dazu. Am Ende ist die fertige Datei winzig im Vergleich zum Basismodell: bei mir rund 85 bis 170 Megabyte statt mehreren Gigabyte. Man kann es sich wie eine Brille vorstellen, die man dem Modell aufsetzt: Das Modell selbst bleibt unverändert, sieht die Welt durch die Brille aber anders.
Der Datensatz: Bilder sammeln und zuschneiden
Für das Keto-Brot/Pizza-LoRA war der Plan, 32 Bilder zu sammeln – 12 für Pizza, 20 für Brot – als Zuschnitte aus 15 Originalfotos von Wikimedia Commons, alle mit freien Lizenzen (CC0, CC BY, CC BY-SA). Tatsächlich durchgelaufen ist bisher nur der Pizza-Teil, „keto_pizza_v1“, mit 12 Bildern, die durch Spiegelung effektiv wie 24 wirken. Der Brot-Teil wartet noch auf eigene Fotos von mir – die habe ich noch nicht gemacht.
Jedes Bild bekommt eine kurze Textbeschreibung, die beim Training genutzt wird, zum Beispiel „ketopizza, cauliflower crust pizza with mushrooms and melted cheese on a wooden board“. Dieses Wort „ketopizza“ am Anfang ist das Auslösewort (Trigger-Wort): Nur wenn es im Prompt steht, wird das gelernte LoRA-Wissen aktiv.
Die eigentliche Trainingsnacht
Trainiert habe ich auf Basis von Z-Image-Turbo (einem frei verfügbaren Bildmodell), mit Rang 32 und einer Lernrate von 1e-4 (0,0001 – legt fest, wie große Lernschritte das Modell pro Durchgang macht), über 1200 Schritte, mit einem Zwischenspeicherpunkt alle 200 Schritte, in den Auflösungen 512 und 768 Pixel. Geplant waren ursprünglich 2000 Schritte, ich habe aber nach 1200 abgebrochen – warum, erkläre ich weiter unten. Das war in der Nacht auf den 1. November, von 2:47 bis 4:24 Uhr (reine Trainingsdauer rund anderthalb Stunden). Wie anstrengend eine ganze Trainingsnacht für die Hardware werden kann, zeigen die folgenden Messwerte aus einer anderen, längeren Nacht Anfang November, in der ich mehrere Läufe hintereinander gefahren habe:
Wie das Training technisch abläuft
Für das Training selbst nutze ich ein Werkzeug namens ai-toolkit. Das bekommt eine Konfigurationsdatei, in der alles Wichtige steht: welches Basismodell ich erweitere (bei mir Z-Image-Turbo), wie viele Schritte trainiert werden sollen, wie groß das LoRA sein soll (der „Rang“ – je größer, desto mehr kann es sich merken, aber desto größer wird auch die Datei) und wo die Trainingsbilder liegen. Dieselben kurzen Bildbeschreibungen wie oben kommen hier wieder zum Einsatz. Das Werkzeug zeigt während des Trainings alle paar hundert Schritte ein Beispielbild, damit ich sehen kann, ob es in die richtige Richtung geht, ohne bis zum Ende warten zu müssen.
Fertig ist das Training, wenn die vorgegebene Schrittzahl erreicht ist oder ich es manuell abbreche – beim Pizza-LoRA zum Beispiel nach 1200 statt der ursprünglich geplanten 2000 Schritte, weil das Ergebnis zu diesem Zeitpunkt schon brauchbar aussah und ich die Rechenzeit sparen wollte.
Die Einbindung in ComfyUI
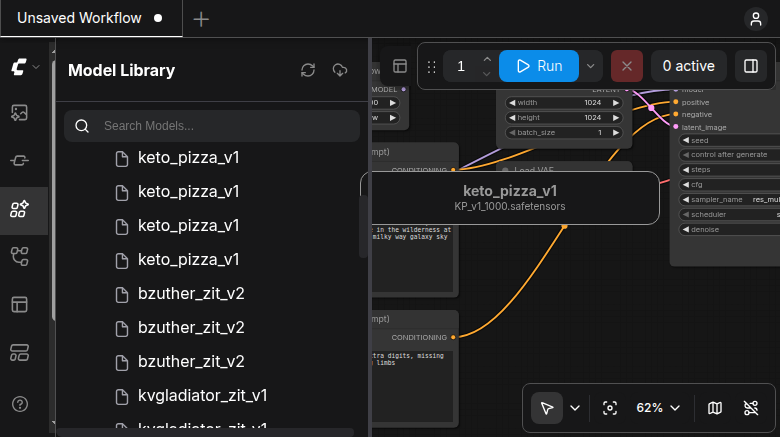
Das fertige LoRA liegt danach einfach als Datei in einem Ordner, den mein Bildgenerierungs-Programm ComfyUI automatisch durchsucht. Dort taucht es dann in der Modell-Bibliothek auf, zusammen mit allen anderen LoRAs, die ich bisher trainiert habe:
Um ein LoRA tatsächlich zu benutzen, baue ich in ComfyUI einen kleinen Baustein namens „Load LoRA“ in meinen Bildgenerierungs-Ablauf ein. Der sitzt zwischen dem Basismodell und dem eigentlichen Bildgenerator: Das Basismodell läuft zuerst durch diesen Baustein, der die gelernten Anpassungen draufrechnet, bevor es weitergeht. Zwei Zahlen stelle ich dabei ein – wie stark der Einfluss auf das Bildmodell sein soll und wie stark auf das Textverständnis. Meistens reicht ein Wert zwischen 0,7 und 1,0.
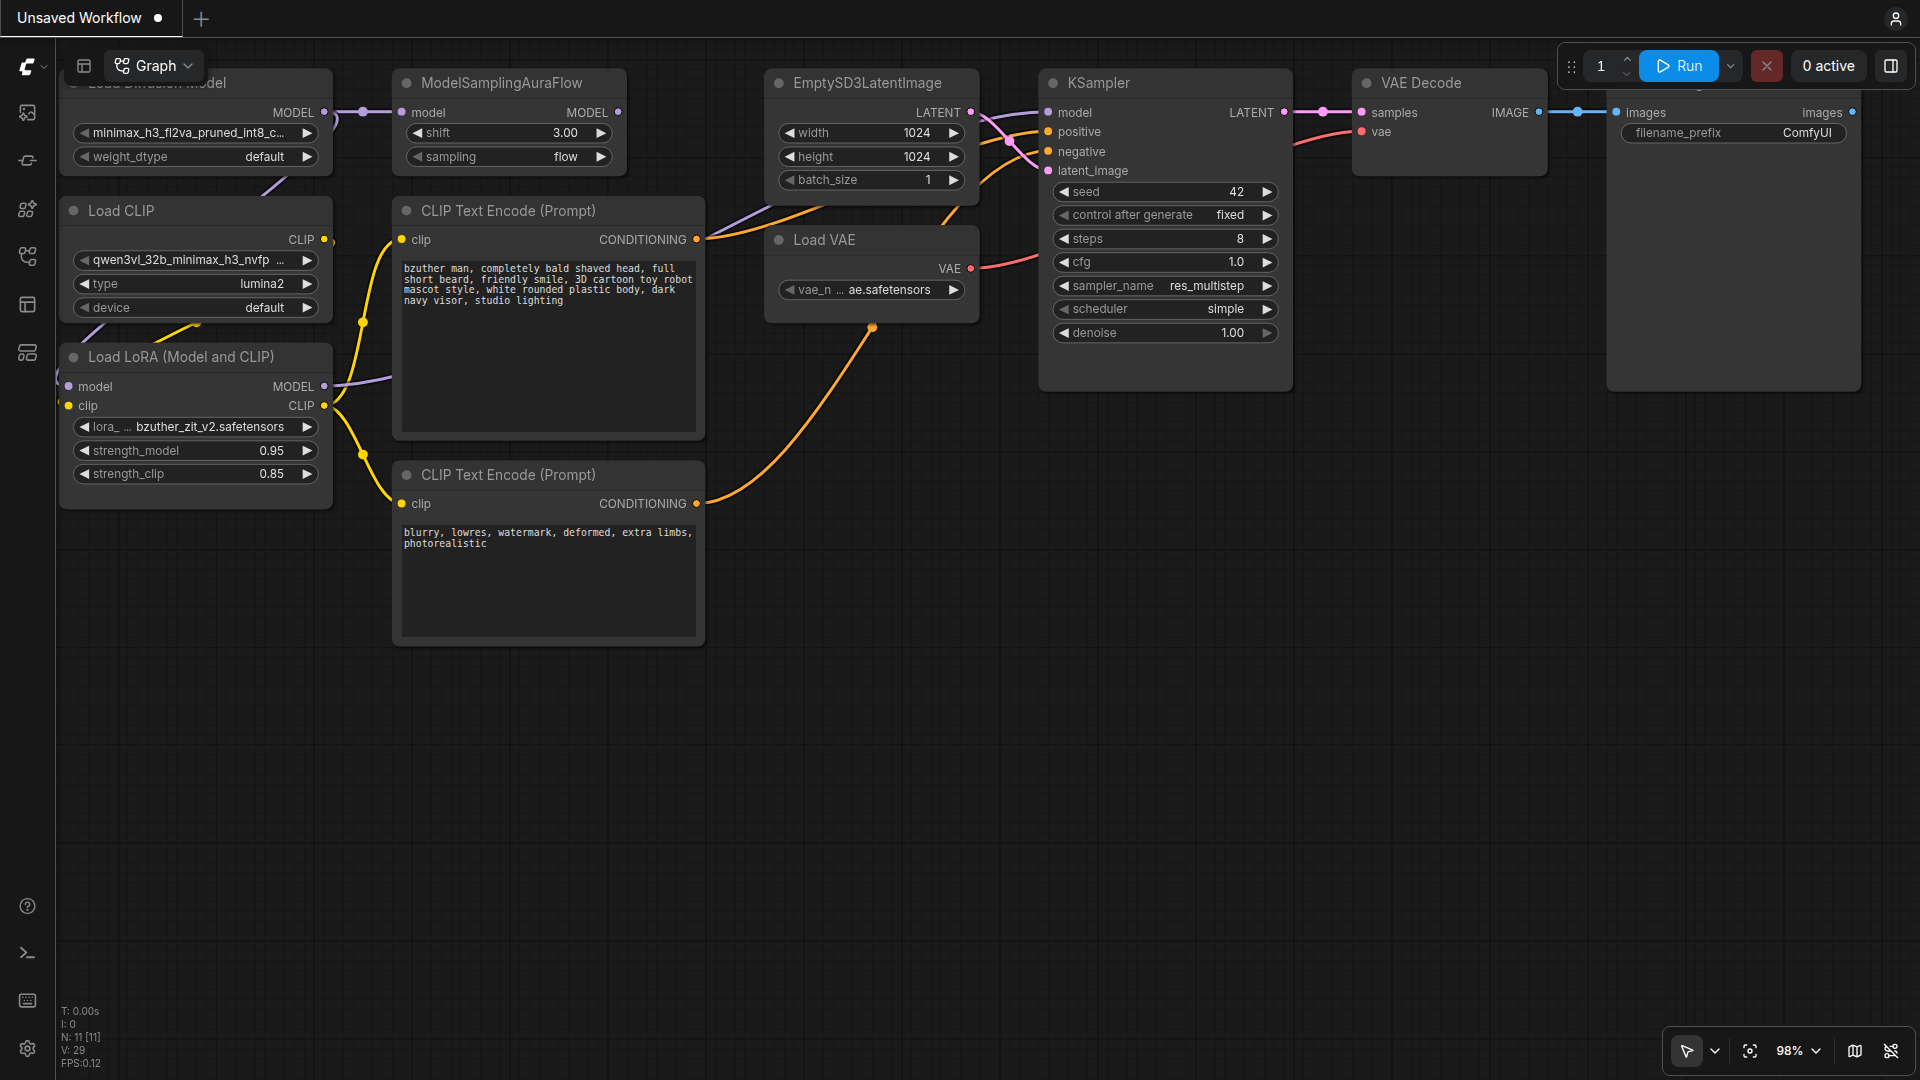
Wichtig ist außerdem das Auslösewort im Text-Prompt – ohne das Wort „bzuther man“ beziehungsweise „ketopizza“ bleibt das LoRA praktisch wirkungslos, selbst wenn es eingebunden ist. Das Modell muss durch dieses Wort erst „wissen“, dass es sein Zusatzwissen jetzt anwenden soll.
Was zuerst schiefging: der Speicher war knapp
Ich habe nur eine Grafikkarte, die sich mein lokaler KI-Assistent und das LoRA-Training teilen müssen. Beim allerersten Versuch – noch ohne festes Zeitfenster – habe ich beides parallel laufen lassen, und das ging nicht gut: Der Trainingslauf hat meinem Assistenten den Grafikspeicher (VRAM) und Arbeitsspeicher weggenommen, bis das Betriebssystem ihn wegen Speichermangel (Out-of-Memory) einfach beendet hat. Beide Prozesse teilen sich denselben Rechner, und wenn ich das nicht vorher abstimme, geht einer von beiden k.o.
Warum nachts? Eine GPU für zwei
Genau deshalb habe ich danach ein festes Nachtfenster von 23:00 bis 5:45 Uhr eingeführt, in dem der Assistent pausiert und die Karte frei für Trainingsläufe ist. Damit das zuverlässig klappt und ich nicht vergesse, den Assistenten wieder zu starten, läuft das automatisch über zeitgesteuerte Systemdienste (systemd-Timer mit Watchdog, der den Assistenten notfalls neu startet).
Vorher und nachher
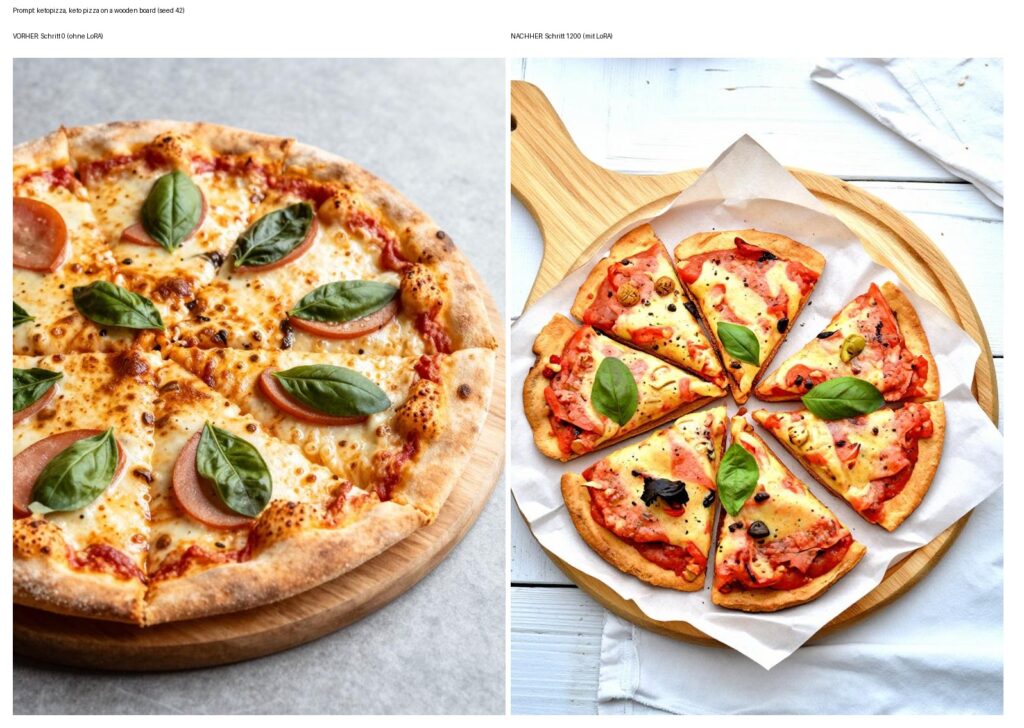
Der Unterschied ist sogar für Laien auf den ersten Blick sichtbar. Links das Bild ganz ohne LoRA: dicker, aufgegangener Rand mit typischen Röstblasen – klassische Pizzeria-Optik. Rechts mit dem fertigen LoRA nach 1200 Schritten: dünnerer, körnigerer Boden, realistischer für eine Low-Carb-Pizza. Noch ist das kein perfektes Ergebnis, aber der Unterschied zeigt, dass das Prinzip funktioniert.
Das zweite Beispiel: ein LoRA von mir selbst
Neben dem Pizza-LoRA gibt es noch ein zweites, ganz anderes Beispiel: ein LoRA, das mein eigenes Gesicht gelernt hat. Der Zweck ist simpel – ich möchte, dass Leser mich in Header-Bildern wiedererkennen – und dass mein Avatar in Illustrationen tatsächlich wie ich aussieht, statt dass jedes Bild ein anderes, zufälliges Gesicht zeigt.
Dafür habe ich 20 Zuschnitte von Fotos von mir selbst verwendet, jeder einzelne von Hand gesichtet – Zuschnitte, auf denen versehentlich fremde Gesichter zu sehen waren, habe ich aussortiert. Jede Bildbeschreibung folgt demselben Muster: „photo of bzuther man“ plus eine kurze Angabe zu Kleidung oder Ort. Die erste brauchbare Version (v2) habe ich am 25. Oktober trainiert, wieder auf Z-Image-Turbo, wieder mit ai-toolkit, Rang 16, Lernrate 1e-4, 1500 Schritte in 512 und 768 Pixel, insgesamt 2 Stunden und 15 Minuten bei rund 36 Gigabyte GPU-Speicher. Die fertige LoRA-Datei ist gerade einmal 85 Megabyte groß.
Was ich dabei gelernt habe
Zwei Dinge haben mich überrascht. Erstens: Wenn ich „completely bald shaved head“ nicht explizit in den Prompt schreibe, erfindet das Modell mir munter Haare dazu – offenbar reicht die reine Bildähnlichkeit nicht, bestimmte Merkmale muss man zusätzlich ausdrücklich in Worten festhalten. Zweitens, und das fand ich spannender: Je stärker ich das Bild verniedliche (zum Beispiel in einem knuffigen „Chibi“-Stil), desto mehr geht die Ähnlichkeit zu mir verloren. In einem eher realistischen Porträt- oder Knetfigur-Stil bleibt sie dagegen gut erhalten.
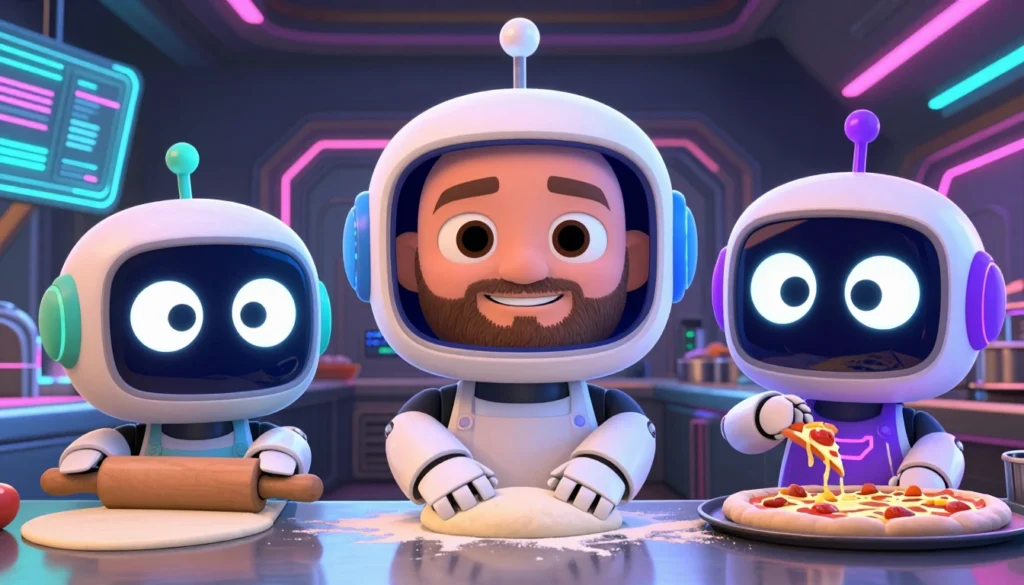
Für das Header-Bild dieses Artikels habe ich deshalb mehrere Varianten mit unterschiedlicher Stilisierung getestet, bis eine dabei war, die tatsächlich nach mir aussieht und gleichzeitig zum Roboter-Maskottchen-Design passt, das ich sonst auf der Seite nutze – im Header backe ich zusammen mit zwei weiteren Roboter-Maskottchen, die meine beiden KI-Assistenten Hermes und OpenClaw darstellen, Pizza in einer Cyberpunk-Küche. Mehr zu den beiden und wie sie sich im Alltag unterscheiden, steht in meinem Vergleich der beiden Assistenten.
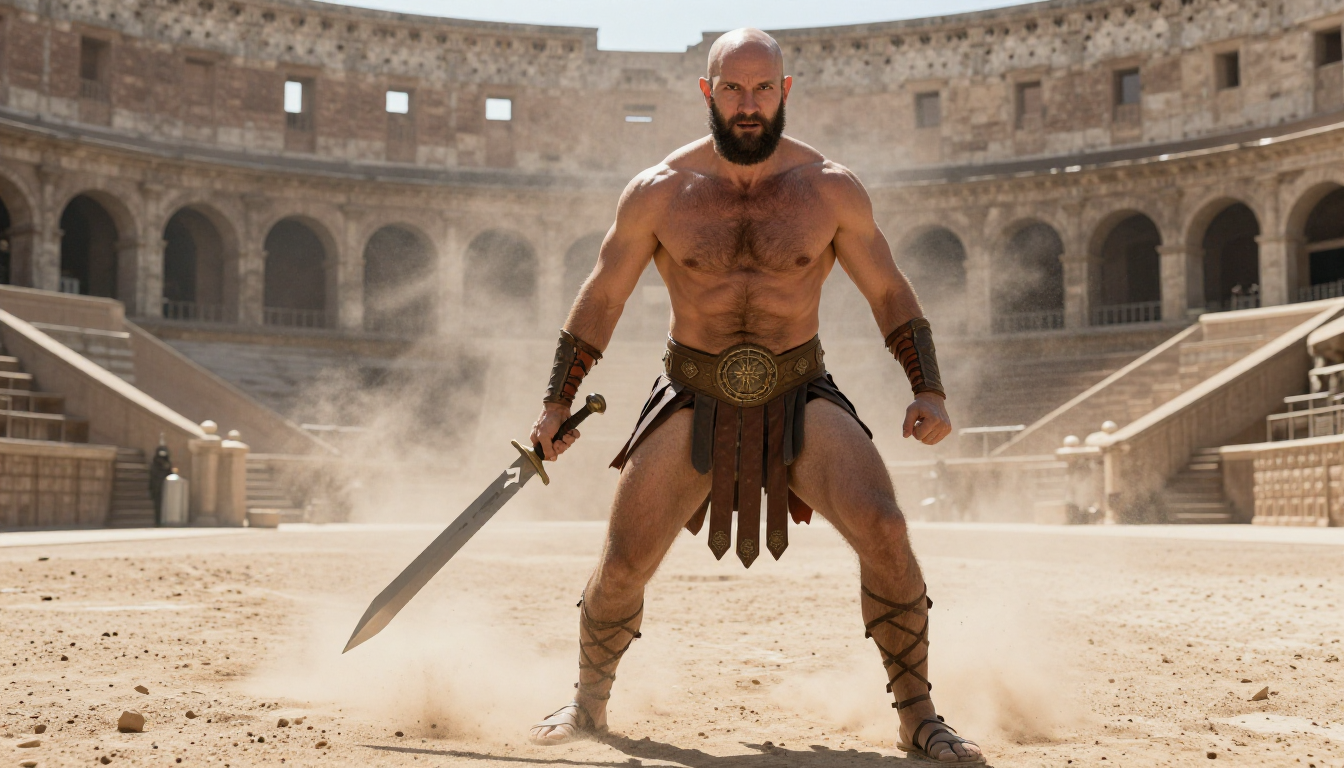
Ein Punkt, bei dem ich inzwischen weitergekommen bin: Für die ersten Trainingsfotos hatte ich ein Gesichtserkennungswerkzeug (InsightFace) zum automatischen Zuschneiden benutzt, dessen vortrainierte Modelle nur für nicht-kommerzielle Zwecke freigegeben sind. Mittlerweile nutze ich dafür MediaPipe (Apache-2.0-Lizenz), ein Werkzeug ohne diese Einschränkung – die Bilder in diesem Artikel (Header und Gladiator-Szene) stammen bereits aus dem damit neu trainierten LoRA „bzuther_zit_v3“. Ehrlich gesagt: In meiner Ähnlichkeits-Messung schneidet die neue Version bisher nicht besser ab als die alte, eher im Gegenteil – die Messung stelle ich gerade auf das neue Verfahren um, belastbare Zahlen dazu folgen in einem Nachtrag.
Fazit und Ausblick
Ein LoRA zu trainieren ist für mich mittlerweile Alltag geworden – nachts, während mein Assistent pausiert, mit klaren Regeln für Speicher und Zeitfenster. Die Ergebnisse sind noch nicht perfekt: Der Pizza-Checkpoint ist noch nicht final ausgewählt, das Brot-LoRA fehlt noch komplett, und bei der neuen Zuschnitt-Methode warte ich noch auf eine belastbare Ähnlichkeits-Messung. Aber das Prinzip – ein kleines, gezieltes Zusatzmodul statt eines komplett neuen Modells – hat sich für mich als der pragmatischste Weg erwiesen, meinen KI-Bildern beizubringen, was ich eigentlich sehen will.
- Eigene Trainingslogs (Pizza-LoRA 1.11.2026, Personen-LoRA 25.10.2026) und GPU-Messwerte (interne Prometheus-Überwachung, Nacht 5./6.11.2026)
- Trainingsbilder Keto-Pizza-LoRA: Wikimedia Commons, Lizenzen CC0 / CC BY / CC BY-SA (Einzelnachweise mit Urheber und Quelllink intern dokumentiert, keine Markenprodukte, keine erkennbaren Personen)
- Basismodell: Z-Image-Turbo (Apache-2.0)
- Trainingswerkzeug: ai-toolkit (ostris, MIT-Lizenz)
- Gesichtszuschnitt (ab LoRA-Version v3): MediaPipe (Google, Apache-2.0)