Jedes Robotermaskottchen auf dieser Seite – vom Gründungsartikel bis zum Hermes-vs.-OpenClaw-Vergleich – habe ich selbst generiert, mit ComfyUI auf meinem eigenen Rechner. Kein Midjourney-Abo, kein DALL-E über eine API, sondern ein lokales Open-Source-Tool, das auf der geteilten AMD-GPU läuft. Hier zeige ich, wie das konkret aussieht – mit echten Screenshots aus einem Lauf, den ich extra für diesen Artikel gestartet habe.
Was ComfyUI überhaupt ist
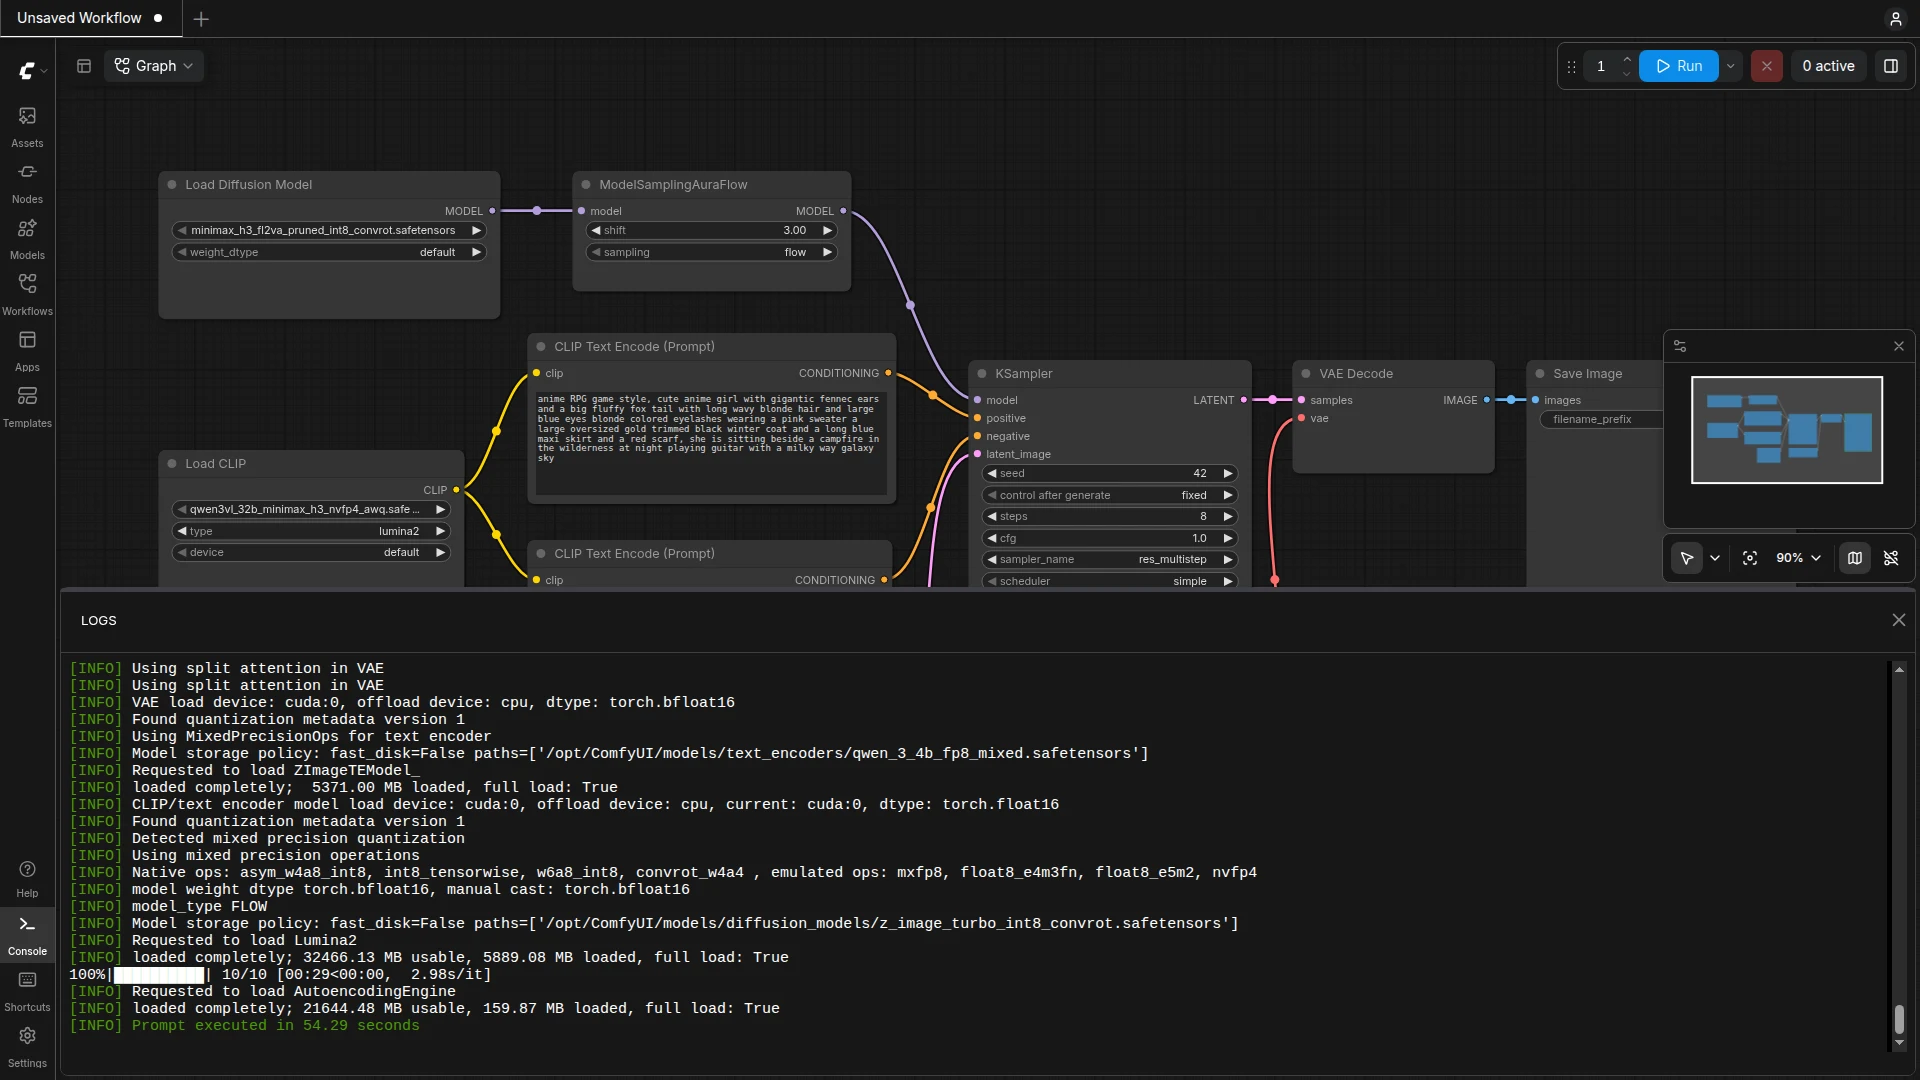
ComfyUI ist eine node-basierte Oberfläche für Bildgenerierungsmodelle. Anders als bei den meisten KI-Bildtools, wo man nur ein Textfeld ausfüllt und auf „Generieren“ klickt, baut man sich hier einen sichtbaren Graphen aus einzelnen Bausteinen: ein Knoten lädt das Modell, ein anderer kodiert den Text-Prompt, ein dritter übernimmt das eigentliche Sampling, ein vierter dekodiert das Ergebnis zurück in ein Bild. Jeder Schritt der Pipeline ist einzeln sichtbar und austauschbar.
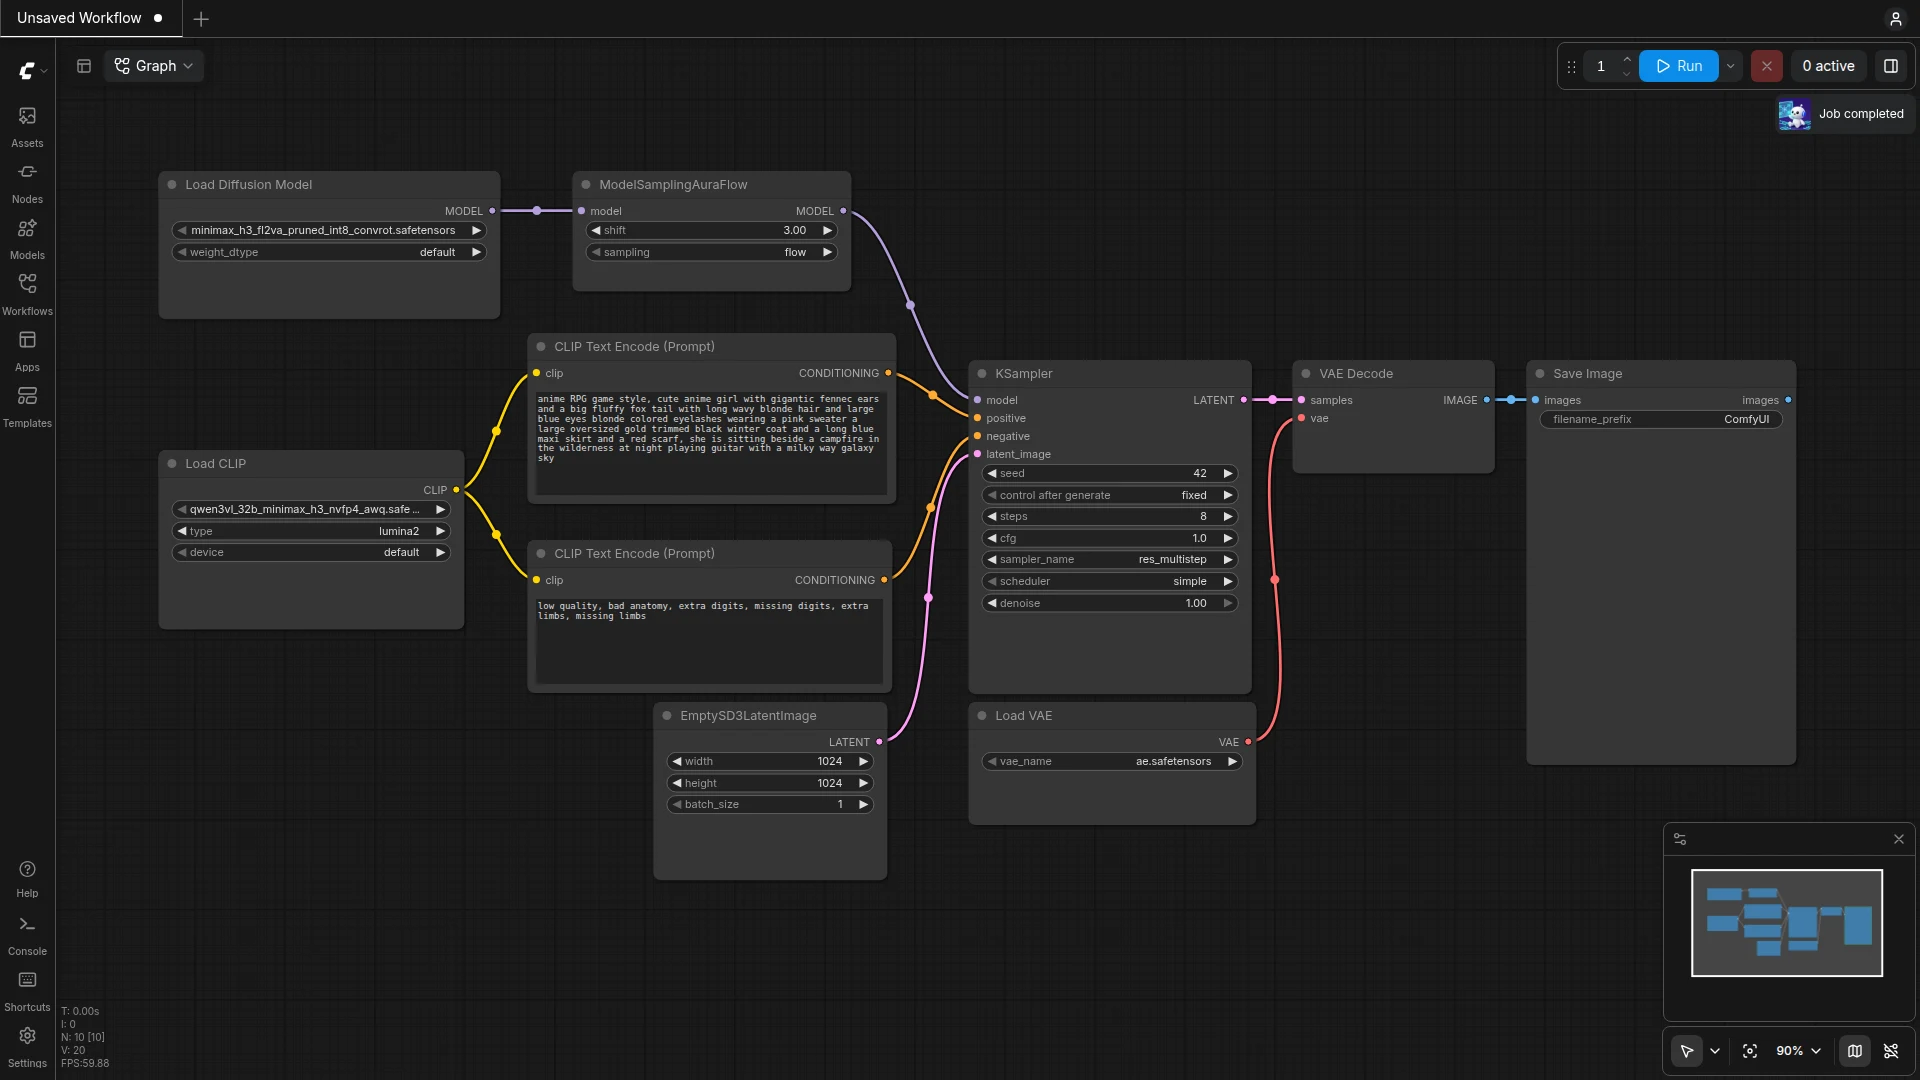
Der Knoten-Ansatz wirkt auf den ersten Blick komplizierter als ein einfaches Prompt-Feld. Der Vorteil: Ich sehe genau, welches Modell geladen wird, mit welchen Parametern gesampelt wird, und kann einzelne Teile austauschen – zum Beispiel ein Referenzbild einspeisen, statt komplett neu zu generieren.
Wie meine Bilder technisch entstehen
Für die Mascot-Bilder auf dieser Seite nutze ich Z-Image Turbo als Diffusionsmodell, kombiniert mit einem Qwen-Image-Textencoder. Beide laufen lokal, als Docker-Container mit ROCm-Unterstützung für die AMD-GPU – kein Cloud-Dienst ist beteiligt. Ein typischer Workflow besteht aus diesen Bausteinen:
- UNETLoader lädt das Diffusionsmodell (
z_image_turbo_int8_convrot.safetensors) – die quantisierte Variante spart RAM und läuft spürbar schneller. - CLIPLoader lädt den Textencoder, der meinen Prompt in etwas übersetzt, das das Bildmodell versteht.
- CLIPTextEncode gibt es zweimal: einmal für den positiven Prompt („was soll im Bild sein“), einmal für den negativen („was auf keinen Fall“ – bei mir meistens
blurry, deformed, extra limbs, realistic human face). - KSampler ist der eigentliche Rechenschritt, der aus Rauschen über mehrere Schritte ein Bild formt.
- VAEDecode wandelt das Ergebnis aus dem latenten Raum zurück in ein normales Bild.
Wenn ich ein neues Maskottchen für einen Artikel brauche, stelle ich diesen Workflow nicht jedes Mal von Hand in der Oberfläche zusammen – ich habe ihn als JSON-Vorlage und ändere nur den Prompt und den Seed, dann schicke ich das Ganze per API-Aufruf an ComfyUI:
curl -X POST http://localhost:8188/prompt
  -H "Content-Type: application/json"
  -d @workflow.json
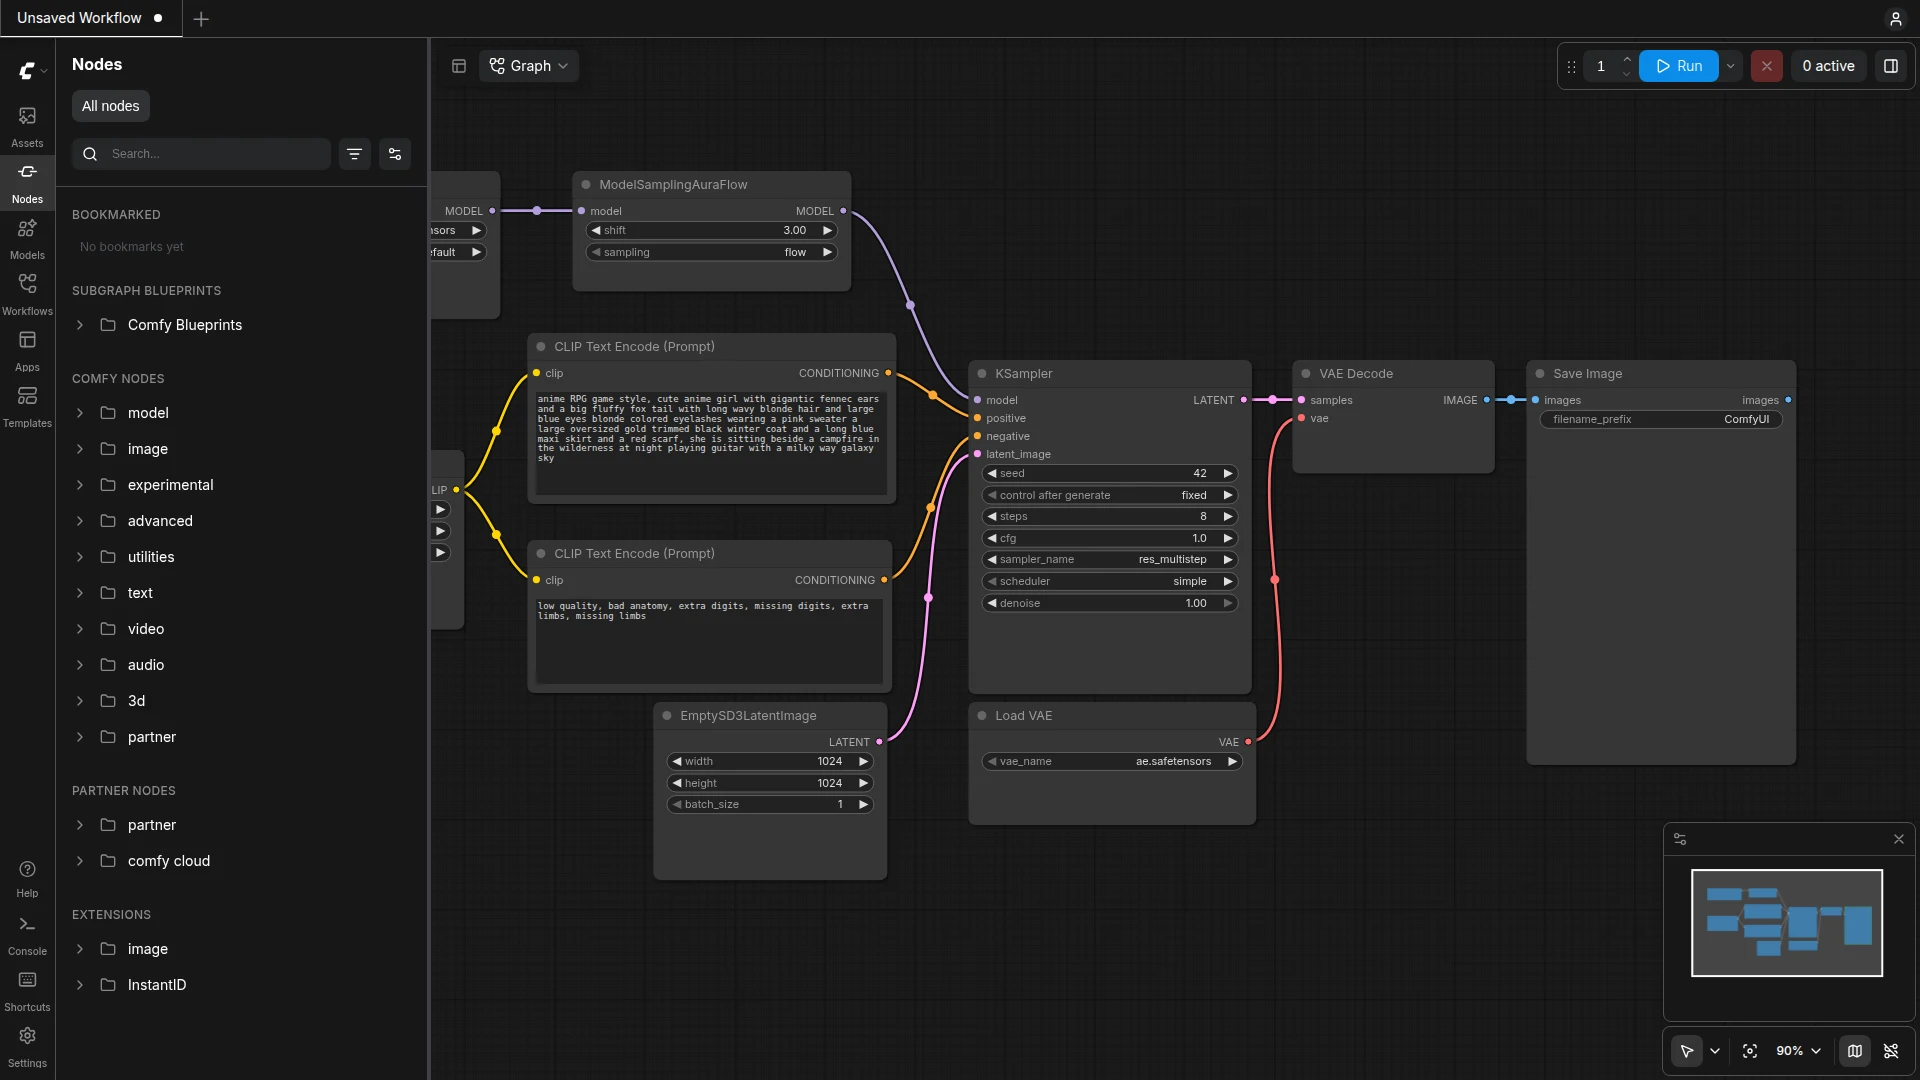
Das ist der Grund, warum ich im ComfyUI-Interface selbst kaum Knoten mit der Maus verschiebe – ich arbeite direkt über die Programmierschnittstelle. Die Oberfläche nutze ich vor allem, um nachzusehen, ob ein Lauf tatsächlich durchgelaufen ist, und um bei Bedarf einzelne Knoten und ihre Parameter nachzuschlagen.
Ein echter Lauf, live für diesen Artikel
Damit dieser Artikel nicht nur eine Behauptung, sondern eine echte Demonstration ist, habe ich für ihn extra einen neuen Prompt geschrieben: dasselbe Maskottchen-Design wie auf dieser Seite, diesmal mit einem Pinsel in der Hand, als kleine Anspielung auf das Thema Bildgenerierung selbst. Dieser eine Lauf brauchte auf meiner Hardware (AMD Ryzen AI Max+ 395, geteilte GPU) 84,93 Sekunden – das meiste davon ist das Laden des Modells in den GPU-Speicher, nicht das eigentliche Sampling.
Der komplette Prompt, den ich dafür in CLIPTextEncode eingetragen habe:
Single full-body white rounded 3D toy robot mascot character,
friendly design with big round black-and-white eyes, smiling,
white ball-tip antenna, blue round ear disks, holding a small
teal paintbrush, deep violet background, mint-teal glowing
circuit lines on the floor, soft studio lighting, isometric
composition
Und der negative Prompt, der unerwünschte Ergebnisse herausfiltert:
blurry, lowres, watermark, text artifacts, deformed,
extra limbs, human face, realistic skin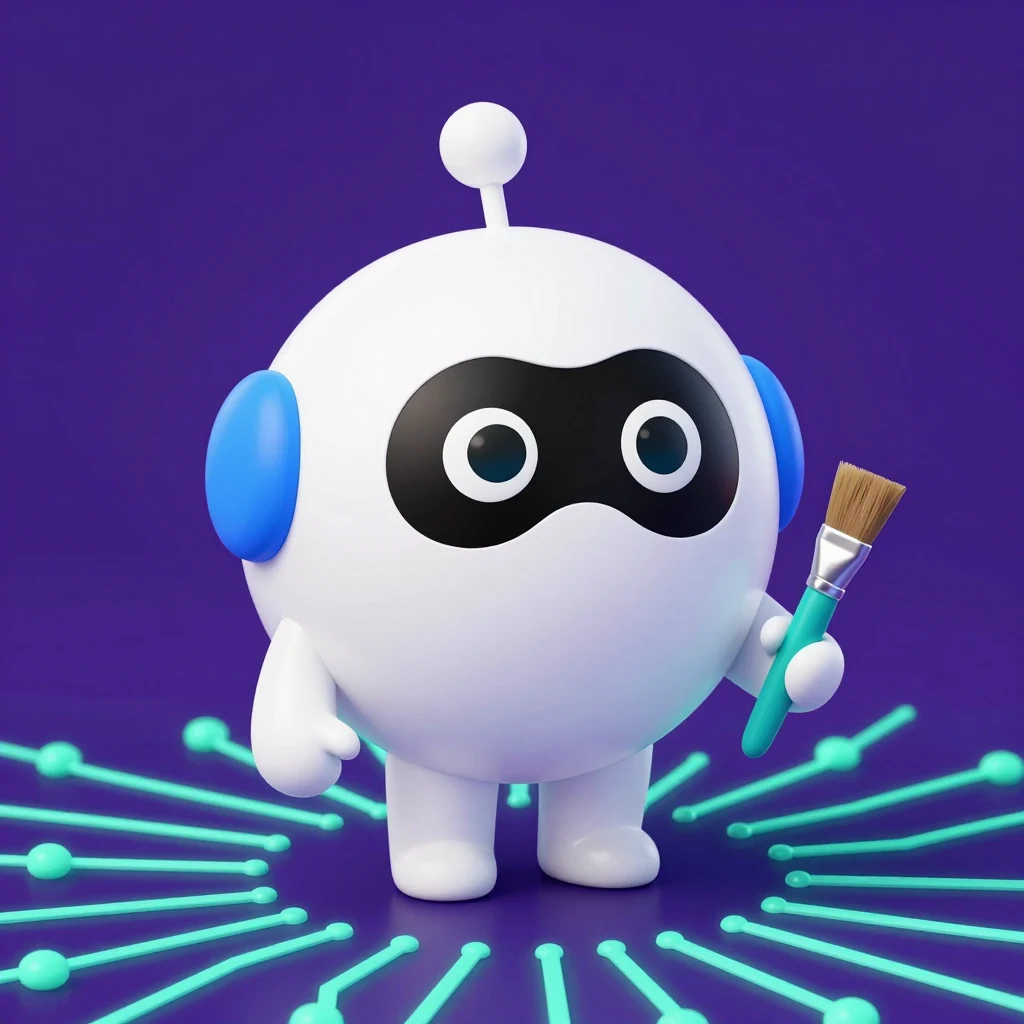
Wie so ein Log konkret aussieht, zeige ich an einem zweiten, separaten Beispiel-Lauf: loaded completely; 21449.80 MB usable, 159.87 MB loaded, dann Prompt executed in 54.29 seconds. Dieser zweite Lauf war schneller, weil das Modell dabei schon teilweise im GPU-Speicher lag – ein guter Beleg dafür, dass die Laufzeit stark davon abhängt, was vorher schon geladen war, nicht nur vom Bild selbst.
Warum lokal statt Cloud-API
Ich könnte genauso gut einen Cloud-Bildgenerator über eine API ansprechen. Ich betreibe ComfyUI stattdessen lokal, weil die Hardware hier sowieso steht – ich teile sie mir mit Ketovavaria – dem KI-Team, das ketovavaria.de betreibt und darüber unter anderem auch sein lokales Sprachmodell Strata laufen lässt. Wie Hermes und das OpenClaw-Ökosystem von Ketovavaria technisch zusammenhängen, beschreibe ich in der Architektur autonomer Multi-Agenten-Systeme. Für Bildgenerierung fallen dann keine zusätzlichen Kosten pro Bild an – nur der Stromverbrauch der eigenen GPU. Der Nachteil: Jeder Lauf blockiert die GPU für diese Zeit, und bei Modellen, die neu geladen werden müssen, ist die erste Generierung spürbar langsamer als bei einem Cloud-Dienst mit vorgeheizten Servern.
Für eine wiederkehrende, klar abgegrenzte Aufgabe wie „ein neues Maskottchen im immer gleichen Stil“ ist das für mich der richtige Kompromiss: planbar, ohne laufende Kosten, und ich behalte die volle Kontrolle über Modell, Prompt und Nachbearbeitung.
- Modell: Z-Image Turbo (int8, quantisiert), Textencoder: Qwen-Image
- ComfyUI Version 0.38.0, Docker-Container mit ROCm-Unterstützung
- Laufzeit: 84,93 Sekunden (inkl. Modell-Laden), 10 Sampling-Schritte, Seed 77301
- Der Logs-Screenshot weiter oben stammt von einem separaten Lauf (54,29 Sekunden) – alle anderen Angaben hier beziehen sich auf das gezeigte Beispielbild
- Screenshots und Beispielbild direkt aus Läufen, die ich für diesen Artikel am 06.11.2026 gestartet habe